Computational Physics - 1
计算物理笔记(一)
On this page
1 Numerical Representation and Errors
1.1 Data Storage and Floating-Point Numbers
- 位(bit)是二进制存储的最小单位, 取值为 0 或 1. 字节(byte): 常用的数据存储单位, 1 byte = 8 bit.
- 整型(int): 表示整数; 浮点(float): 表示实数. 数值精度受到存储位数限制, 浮点数常分为单精度浮点数与双精度浮点数.
1.1.1 Single Precision Floating-Point Numbers
以下采用 IEEE 754 的 binary32 格式.1 占用 4 byte (32 bit), 正规数具有 24 bit 有效二进制精度, 通常约 7 位十进制有效数字. 字段结构如下.
32 bit 单精度浮点数的字段结构为 S | EEEEEEEE | FFFFFFFFFFFFFFFFFFFFFFF, 即 1 个符号位, 8 个指数位和 23 个尾数位.
S 为符号位: 0 为正, 1 为负.
E 为指数位, 表示 2 的幂次. 存在 127 的偏移量, 即
\[\text{实际指数}=\text{存储指数}-127\]除去全 0 (00000000)和全 1 (11111111)(有其他用途), 指数范围为 1 至 254 (00000001 至 11111110), 于是正规数的实际指数范围为 \(-126\sim127\), 正的正规数范围为
\[2^{-126}\leq x\leq (2-2^{-23})2^{127}\]即约 \(1.1755\times10^{-38}\) 至 \(3.4028\times10^{38}\). 这是可表示数的范围, 不表示其中每个实数都能精确存储.
F 为小数位,
\[(-1)^S \times (1.F)_2 \times 2^{E-127}\]FFF...FFF是 23 bit 字段, \((0.F)_2\) 为其二进制小数值. 对 \(1\leq E\leq254\) 的正规数, 有效数为 \((1.F)_2\), 隐含的前导 1 不另占存储位. 数值为一些特殊情况: \(E=0, F\neq0\) 为次正规数(subnormal number), 值为
\[(-1)^S \times 2^{-126} \times (0.F)_2\]最小正值为 \(2^{-149}\approx1.4013\times10^{-45}\). \(E=0,F=0\) 表示带符号的零 \(+0\) 或 \(-0\). \(E=255, F=0\), 值为
\[(-1)^S\infty\]\(E=255, F\neq0\) 表示 NaN(not a number), 可用于表示无效运算等产生的非数值结果.
Example 将 \(-5.75\) 转化为单精度浮点数.
Solution 先将 \(-5.75\) 转化为二进制数:
\[(-5.75)_{10}=-(101.11)_2=-(1.0111)_2\times2^2\]于是得到: 符号位 \(S=1\), 指数位 \(E=10000001\), 小数位 \(F=0111000\cdots 000\)
1.1.2 Double Precision Floating-Point Numbers
以下采用 IEEE 754 的 binary64 格式.2 占用 8 byte (64 bit), 正规数具有 53 bit 有效二进制精度, 通常约 16 位十进制有效数字. 64 bit 分为 1 个符号位, 11 个指数位和 52 个小数位.
\[\text{S}\underbrace{\text{EEE}\cdots\text{EEE}}_{\text{11个 E}}\underbrace{\text{FFF}\cdots\text{FFF}}_{\text{52个 F}}\]S 为符号位: 0 为正, 1 为负.
E 为指数位, 偏移量为 1023.
F 为 52 bit 小数字段. 对 \(1\leq E\leq2046\) 的正规数, 值为
\[(-1)^S\times(1.F)_2\times2^{E-1023}\]正的正规数范围为
\[\begin{gathered} 2^{-1022}\quad\text{至}\quad (2-2^{-52})2^{1023} \\ 2.2251\times10^{-308}\quad\text{至}\quad 1.7977\times10^{308} \end{gathered}\]第二行给出近似十进制范围.
类别 编码条件 次正规数 \(E=0,F\neq0\) 带符号的零 \(E=0,F=0\) 带符号的无穷大 \(E=2047,F=0\) NaN \(E=2047,F\neq0\) 次正规数的数值为
\[(-1)^S(0.F)_2 2^{-1022}\]最小正值为
\[2^{-1074}\approx4.9407\times10^{-324}\]
1.2 Computational Errors
Definition 舍入误差(round-off error). 输入数据的浮点表示及计算结果舍入引起的误差.
Definition 截断误差(truncation error). 例如 Taylor 展开的计算中
\[e^x=1+x+\frac{x^2}{2!}+\frac{x^3}{3!}+\cdots+\frac{x^n}{n!}+R_n(x)\]其中 Lagrange remainder
\[R_n(x)=\frac{\mathrm{e}^\xi}{(n+1)!}x^{n+1},\qquad \min(0,x)\lt\xi\lt\max(0,x),\quad x\neq0\]\(x=0\) 时 \(R_n(0)=0\).
2 Linear Algebra Methods
以下矩阵和向量取实数值; 方程组中的系数矩阵为方阵, QR 和 SVD 小节另外讨论矩形矩阵. 复数推广需要把内积和正交分解中的转置改为 Hermitian 共轭转置. 该部分旨在求解线性方程组
\[\mathbf{A} \cdot { \mathbf{x} } = { \mathbf{b} }\]2.1 Norms *
2.1.1 Vector Norms
向量的范数可以用来测量向量的长度, 定义:
1-范数
\[\|\mathbf{x}\|_1=|x_0|+|x_1|+\cdots+|x_{n-1}|\]即曼哈顿距离.
2-范数
\[\|\mathbf{x}\|_2=\sqrt{|x_0|^2+|x_1|^2+\cdots+|x_{n-1}|^2}\]即 Euclidean distance.
\(\infty\)-范数
\[\|\mathbf{x}\|_\infty=\max_{0\leq i\leq n-1}|x_i|\]\(p\)-范数, \(1\leq p\lt\infty\)
\[\|\mathbf{x}\|_p=(|x_0|^p+|x_1|^p+\cdots+|x_{n-1}|^p)^{1/p}\]
Cauchy-Schwarz inequality:
\[|\mathbf{x}^{\mathsf{T}}\mathbf{y}|\leq \|\mathbf{x}\|_2\|\mathbf{y}\|_2\]三角不等式:
\[\|\mathbf{x}+\mathbf{y}\|\leq \|\mathbf{x}\|+\|\mathbf{y}\|\]2.1.2 Matrix Norms
\[\begin{aligned} \|\mathbf{A}\|_F&=\sqrt{\sum_{i=0}^{m-1}\sum_{j=0}^{n-1}|a_{ij}|^2},\\ \|\mathbf{A}\|_\infty&=\max_{0\leq i\leq m-1}\sum_{j=0}^{n-1}|a_{ij}|,\\ \|\mathbf{A}\mathbf{z}\|&\leq \|\mathbf{A}\|\cdot\|\mathbf{z}\|. \end{aligned}\]这里矩阵范数与向量范数须相容, 例如 \(\|\mathbf{A}\mathbf{z}\|_\infty\leq\|\mathbf{A}\|_\infty\|\mathbf{z}\|_\infty\) 和 \(\|\mathbf{A}\mathbf{z}\|_2\leq\|\mathbf{A}\|_F\|\mathbf{z}\|_2\). 诱导 2-范数定义为 \(\|\mathbf{A}\|_2=\max_{\mathbf{z}\neq0}\|\mathbf{A}\mathbf{z}\|_2/\|\mathbf{z}\|_2\); 它通常不等于 Frobenius 范数.
对于可逆方阵, 可以定义条件数:3
\[K(\mathbf{A})=\|\mathbf{A}\|\cdot\|\mathbf{A}^{-1}\|\]条件数度量问题对输入扰动的敏感性, 与求解算法是否数值稳定是不同的概念. 对诱导 2-范数, \(K_2(\mathbf{A})=\sigma_{\max}/\sigma_{\min}\). 若只扰动右端且 \(\mathbf{b}\neq0\), 则
\[\frac{\|\delta\mathbf{x}\|}{\|\mathbf{x}\|}\leq K(\mathbf{A})\frac{\|\delta\mathbf{b}\|}{\|\mathbf{b}\|}.\]可用可逆矩阵 \(\mathbf{M}\) 作左预条件, 求解 \(\mathbf{M}^{-1}\mathbf{A}\mathbf{x}=\mathbf{M}^{-1}\mathbf{b}\), 目标是改善条件数或迭代收敛, 但一般不能保证条件数接近 1. 对称正定问题使用 CG 时, 还须采用保持其对称正定结构的预条件形式.
2.2 Gaussian Elimination
Gauss 消元法是最经典的求解线性方程组的方法, 考虑线性方程组:
\[\begin{pmatrix} a_{11} & a_{12} & a_{13} & a_{14}\\ a_{21} & a_{22} & a_{23} & a_{24}\\ a_{31} & a_{32} & a_{33} & a_{34}\\ a_{41} & a_{42} & a_{43} & a_{44} \end{pmatrix} \begin{pmatrix} x_1\\ x_2\\ x_3\\ x_4 \end{pmatrix} = \begin{pmatrix} w_1\\ w_2\\ w_3\\ w_4 \end{pmatrix}.\]以下无换行公式要求各步主元非零; 对非奇异方阵可通过主元选取避免零主元. 逐列消元, 先消去第一列:
\[\begin{pmatrix} a_{11} & a_{12} & a_{13} & a_{14}\\ 0 & a_{22}-\dfrac{a_{21}a_{12}}{a_{11}} & a_{23}-\dfrac{a_{21}a_{13}}{a_{11}} & a_{24}-\dfrac{a_{21}a_{14}}{a_{11}}\\ 0 & a_{32}-\dfrac{a_{31}a_{12}}{a_{11}} & a_{33}-\dfrac{a_{31}a_{13}}{a_{11}} & a_{34}-\dfrac{a_{31}a_{14}}{a_{11}}\\ 0 & a_{42}-\dfrac{a_{41}a_{12}}{a_{11}} & a_{43}-\dfrac{a_{41}a_{13}}{a_{11}} & a_{44}-\dfrac{a_{41}a_{14}}{a_{11}} \end{pmatrix} \begin{pmatrix} x_1\\ x_2\\ x_3\\ x_4 \end{pmatrix} = \begin{pmatrix} y_1\\ w_2^{(2)}\\ w_3^{(2)}\\ w_4^{(2)} \end{pmatrix}.\]可以把方程组写成如下形式:
\[\begin{pmatrix} b_{11} & b_{12} & b_{13} & b_{14}\\ 0 & a_{22}^{(2)} & a_{23}^{(2)} & a_{24}^{(2)}\\ 0 & a_{32}^{(2)} & a_{33}^{(2)} & a_{34}^{(2)}\\ 0 & a_{42}^{(2)} & a_{43}^{(2)} & a_{44}^{(2)} \end{pmatrix} \begin{pmatrix} x_1\\ x_2\\ x_3\\ x_4 \end{pmatrix} = \begin{pmatrix} y_1\\ w_2^{(2)}\\ w_3^{(2)}\\ w_4^{(2)} \end{pmatrix}.\]则新, 旧系数的关系为:
\[\begin{aligned} &b_{1k}=a_{1k}, &&k=1,2,3,4, &&a_{ik}^{(2)}=a_{ik}-\frac{a_{i1}a_{1k}}{a_{11}}, &&i,k=2,3,4,\\ &y_1=w_1, && &&w_i^{(2)}=w_i-\frac{a_{i1}w_1}{a_{11}}, &&i=2,3,4. \end{aligned}\]再以此类推, 向前消元, 得到系数的关系:
\[\begin{aligned} &a_{ik}^{(m+1)}=a_{ik}^{(m)}-\frac{a_{im}^{(m)}a_{mk}^{(m)}}{a_{mm}^{(m)}}, &&i,k=m+1,m+2,\cdots,n,\\ &w_i^{(m+1)}=w_i^{(m)}-\frac{a_{im}^{(m)}w_m^{(m)}}{a_{mm}^{(m)}}, &&i=m+1,m+2,\cdots,n. \end{aligned}\]最终变成上三角矩阵:
\[\begin{pmatrix} b_{11} & b_{12} & b_{13} & b_{14}\\ 0 & b_{22} & b_{23} & b_{24}\\ 0 & 0 & b_{33} & b_{34}\\ 0 & 0 & 0 & b_{44} \end{pmatrix} \begin{pmatrix} x_1\\ x_2\\ x_3\\ x_4 \end{pmatrix} = \begin{pmatrix} y_1\\ y_2\\ y_3\\ y_4 \end{pmatrix}.\]向后回代得到最终的解:
\[x_m=\frac{1}{b_{mm}}\left(y_m-\sum_{k=m+1}^{n}b_{mk}x_k\right),\qquad m=n,n-1,\cdots,1.\]Partial Pivoting 列主元消元法是 Gauss 消元法的稳定性改进.
每次消元前, 先在第 \(m\) 列的第 \(m\) 行及以下寻找绝对值最大的元素, 将其所在行与第 \(m\) 行交换, 再进行普通 Gauss 消元. 这样可以避免主元 \(a_{mm}^{(m)}\) 太小时放大舍入误差.
2.3 Augmented Matrix Elimination *
增广矩阵把方程 \(\mathbf{A}\mathbf{x}=\mathbf{y}\) 的系数和右端合在一起, 对两者同时作相同行变换. 本节初始右端记为 \(\mathbf{y}\):
\[\tilde{\mathbf{A}}=[\mathbf{A},\mathbf{y}] = \begin{pmatrix} a_{11} & a_{12} & a_{13} & \cdots & a_{1n} & y_1\\ a_{21} & a_{22} & a_{23} & \cdots & a_{2n} & y_2\\ a_{31} & a_{32} & a_{33} & \cdots & a_{3n} & y_3\\ \vdots & \vdots & \vdots & \ddots & \vdots & \vdots\\ a_{n1} & a_{n2} & a_{n3} & \cdots & a_{nn} & y_n \end{pmatrix}.\]第 \(m\) 次消元, 把第 \(m\) 列元素消为零:
\[E_j'=E_j-\frac{a_{jm}^{(m)}}{a_{mm}^{(m)}}E_m,\qquad j=m+1,m+2,\cdots,n.\]得到上三角方程 \(\mathbf{B}\mathbf{x}=\mathbf{c}\) 后, 从 \(i=n\) 到 \(1\) 依次回代 \(x_i=(c_i-\sum_{j=i+1}^n b_{ij}x_j)/b_{ii}\), 要求主元非零. 右端 \(\mathbf{c}\) 须使用经过同样行变换后的值. 主元选取时也须交换整行, 包括右端列.
2.4 Gauss-Jordan Elimination *
继续消元法是增广矩阵法的变种, 在得到上三角矩阵后继续消元, 得到对角矩阵:
\[\begin{pmatrix} a_{11}^{(1)} & 0 & 0 & \cdots & 0 & w_1^{(1)}\\ 0 & a_{22}^{(2)} & 0 & \cdots & 0 & w_2^{(2)}\\ 0 & 0 & a_{33}^{(3)} & \cdots & 0 & w_3^{(3)}\\ \vdots & \vdots & \vdots & \ddots & \vdots & \vdots\\ 0 & 0 & 0 & \cdots & a_{nn}^{(n)} & w_n^{(n)} \end{pmatrix}.\]向后回代得到方程的解:
\[x_m=\frac{w_m^{(m)}}{a_{mm}^{(m)}},\qquad m=n,n-1,\cdots,1.\]这种方法对于求解相似的方程组十分有效:
\[\begin{cases} \mathbf{A}\mathbf{x}=\mathbf{b}_1,\\ \mathbf{A}\mathbf{x}=\mathbf{b}_2. \end{cases}\]可以将多个右端同时增广, 或保存并复用完整的行变换来处理新的右端. 仅保存最终对角系数矩阵, 不能直接把未变换的新右端代入. 多个右端也常通过复用 LU 分解来求解.
2.5 LU Decomposition
2.5.1 LU Decomposition
LU 分解法是将系数矩阵 \(\mathbf{A}\) 分解为一个下三角矩阵 \(\mathbf{L}\) 和一个上三角矩阵 \(\mathbf{U}\) 的乘积
\[\mathbf{L}\mathbf{U} = \mathbf{A}\]设 \(\mathbf{L} \mathbf{y} = \mathbf{b}\), 方程化为 \(\mathbf{U} \mathbf{x} = \mathbf{y}\). 以下无主元公式要求消元主元非零; 实际计算通常使用部分主元选取, 用置换矩阵 \(\mathbf{P}\) 记录行交换, 左乘表示重排行. 写成 \(\mathbf{P}\mathbf{A}=\mathbf{L}\mathbf{U}\), 并把前代右端改为 \(\mathbf{P}\mathbf{b}\).
对于第一个方程 \(\mathbf{L}\mathbf{y}=\mathbf{b}\), 向前回代得到方程的解:
\[\begin{aligned} y_1 &= \frac{b_1}{l_{11}},\\ y_m &= \frac{1}{l_{mm}}\left(b_m-\sum_{k=1}^{m-1}l_{mk}y_k\right), \qquad m=2,3,\cdots,n. \end{aligned}\]对于第二个方程 \(\mathbf{U}\mathbf{x}=\mathbf{y}\), 向后回代得到方程的解:
\[\begin{aligned} x_n &= \frac{y_n}{\beta_{nn}},\\ x_m &= \frac{1}{\beta_{mm}}\left(y_m-\sum_{k=m+1}^{n}\beta_{mk}x_k\right), \qquad m=n-1,n-2,\cdots,1. \end{aligned}\]
Doolittle 算法求解 \(\mathbf{L}\) 和 \(\mathbf{U}\): 按照行优先的顺序计算 \(\mathbf{L}\) 和 \(\mathbf{U}\) 的元素. 不妨将 \(\mathbf{L}\) 的对角元素都设为 1(这是合理的, 因为可以把 \(\mathbf{U}\) 的对角元乘一个相应的系数). 即
\[\mathbf{A} = \begin{pmatrix} 1 & 0 & 0 & \cdots & 0\\ \alpha_{21} & 1 & 0 & \cdots & 0\\ \alpha_{31} & \alpha_{32} & 1 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ \alpha_{n1} & \alpha_{n2} & \alpha_{n3} & \cdots & 1 \end{pmatrix} \begin{pmatrix} \beta_{11} & \beta_{12} & \beta_{13} & \cdots & \beta_{1n}\\ 0 & \beta_{22} & \beta_{23} & \cdots & \beta_{2n}\\ 0 & 0 & \beta_{33} & \cdots & \beta_{3n}\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & \beta_{nn} \end{pmatrix}.\]对于第 1 行, 先计算 \(\mathbf{U}\) 的第一行元素
\[\beta_{1j}=a_{1j},\qquad j=1,2,\cdots,n.\]因为 \(\mathbf{L}\) 的第一行元素为 \((1,0,0,\cdots,0)\).
再求解 \(\mathbf{L}\) 的第一列:
\[\alpha_{i1}\beta_{11} = a_{i1} \implies \alpha_{i1} = \frac{a_{i1}}{\beta_{11}}, \qquad i=1,2,\cdots,n.\]再从 2 到 \(n-1\), 依次进行递推. 先求 \(\mathbf{U}\) 的第 \(i\) 个对角元素.
\[a_{ii} = \sum_{k=1}^{i-1}\alpha_{ik}\beta_{ki}+\beta_{ii} \implies \beta_{ii} = a_{ii}-\sum_{k=1}^{i-1}\alpha_{ik}\beta_{ki}.\]再求 \(\mathbf{U}\) 的第 \(i\) 行非对角元素:
\[a_{ij} = \sum_{k=1}^{i-1}\alpha_{ik}\beta_{kj}+\beta_{ij} \implies \beta_{ij} = a_{ij}-\sum_{k=1}^{i-1}\alpha_{ik}\beta_{kj}, \qquad j=i+1,i+2,\cdots,n.\]下面来求 \(\mathbf{L}\) 的第 \(i\) 列元素
\[a_{ji}=\sum_{k=1}^{i-1}\alpha_{jk}\beta_{ki}+\alpha_{ji}\beta_{ii} \implies \alpha_{ji}=\frac{1}{\beta_{ii}}\left(a_{ji}-\sum_{k=1}^{i-1}\alpha_{jk}\beta_{ki}\right), \qquad j=i+1,i+2,\cdots,n.\]最后求 \(\mathbf{U}\) 的第 \(n\) 个对角元素.
\[a_{nn} = \sum_{k=1}^{n-1}\alpha_{nk}\beta_{kn}+\beta_{nn} \implies \beta_{nn} = a_{nn}-\sum_{k=1}^{n-1}\alpha_{nk}\beta_{kn}.\]
Remark Gauss 消元与 LU 的关系: 不换行的 Gauss 消元中, 消元后的上三角矩阵就是 \(\mathbf{U}\). 第 \(j\) 列消元时使用的乘数
\[m_{ij}=\frac{a_{ij}^{(j)}}{a_{jj}^{(j)}},\qquad i=j+1,\cdots,n\]填入 \(\mathbf{L}\) 的第 \(i\) 行第 \(j\) 列, 且 \(\mathbf{L}\) 的对角元为 1. 因此, 从 Gauss 消元过程可以直接读出 \(\mathbf{A}=\mathbf{L}\mathbf{U}\): \(\mathbf{U}\) 是消元结果, \(\mathbf{L}\) 记录消元乘数.
Remark 由 LU 分解求逆矩阵和行列式: 若 \(\mathbf{A}=\mathbf{L}\mathbf{U}\), 则
\[\mathbf{A}^{-1}=\mathbf{U}^{-1}\mathbf{L}^{-1}, \qquad \det(\mathbf{A})=\det(\mathbf{L})\det(\mathbf{U}).\]对于 Doolittle 分解, \(\mathbf{L}\) 是单位下三角矩阵, 因此 \(\det(\mathbf{L})=1\), 从而
\[\det(\mathbf{A})=\det(\mathbf{U})=\prod_{i=1}^{n}\beta_{ii}.\]若 \(\mathbf{P}\mathbf{A}=\mathbf{L}\mathbf{U}\), 则须计入行置换符号:
\[\det(\mathbf{A})=\det(\mathbf{P})\prod_{i=1}^{n}\beta_{ii}.\]2.5.2 LU Decomposition for Tridiagonal Matrices
对于三对角矩阵 \(\mathbf{A}\), 可以写作
\[\mathbf{A}= \begin{pmatrix} b_1 & c_1 & 0 & \cdots & 0\\ a_2 & b_2 & c_2 & \cdots & 0\\ 0 & a_3 & b_3 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & b_n \end{pmatrix}\]以三对角矩阵为系数矩阵的线性方程组 \(\mathbf{A}\mathbf{x}=\mathbf{f}\):
\[a_i x_{i-1}+b_i x_i+c_i x_{i+1}=f_i,\qquad i=1,2,\cdots,n.\]其中 \(a_1=0, c_n=0\).
可以作针对三对角矩阵的一类特殊的 LU 分解(称为 Thomas algorithm)
\[\mathbf{A} =\mathbf{L}\mathbf{U} = \begin{pmatrix} 1 & 0 & 0 & \cdots & 0\\ \alpha_2 & 1 & 0 & \cdots & 0\\ 0 & \alpha_3 & 1 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & 1 \end{pmatrix} \begin{pmatrix} \beta_1 & c_1 & 0 & \cdots & 0\\ 0 & \beta_2 & c_2 & \cdots & 0\\ 0 & 0 & \beta_3 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & \beta_n \end{pmatrix}.\]即 \(\mathbf{L}\) 仅有下次对角, 且主对角为 \(1\), \(\mathbf{U}\) 仅有与 \(\mathbf{A}\) 一致的上次对角. 递推关系为
\[\beta_1 = b_1,\qquad \alpha_i = \frac{a_i}{\beta_{i-1}}\qquad \beta_i = b_i-\alpha_i c_{i-1},\qquad i=2,3,\cdots,n.\]该无主元递推要求所有主元 \(\beta_i\neq0\); 严格对角占优或对称正定等条件可保证不出现零主元. 一般非奇异三对角矩阵仍可能需要主元选取. Thomas 算法复杂度为 \(O(n)\).
2.6 LDL Transpose Decomposition *
对于对称正定矩阵, 可以作 \(\mathbf{L}\mathbf{D}\mathbf{L}^{\mathsf{T}}\) 分解. 若 \(\mathbf{A}\) 满足
\[\begin{aligned} \mathbf{A} &= \mathbf{A}^{\mathsf{T}},\\ \mathbf{x}^{\mathsf{T}}\mathbf{A}\mathbf{x} &>0,\qquad \forall \mathbf{x}\neq\mathbf{0}, \end{aligned}\]则可写成
\[\mathbf{A}=\mathbf{L}\mathbf{D}\mathbf{L}^{\mathsf{T}}.\]其中 \(\mathbf{L}\) 为单位下三角矩阵, \(\mathbf{D}\) 为正对角矩阵. 这里仅讨论对称正定情形; 一般不定对称矩阵可能需要置换及含 \(2\times2\) 块的 \(\mathbf{D}\). 三维情形下:
\[\mathbf{A} = \begin{pmatrix} a_{11} & a_{12} & a_{13}\\ a_{12} & a_{22} & a_{23}\\ a_{13} & a_{23} & a_{33} \end{pmatrix} = \begin{pmatrix} 1 & 0 & 0\\ l_{21} & 1 & 0\\ l_{31} & l_{32} & 1 \end{pmatrix} \begin{pmatrix} d_{11} & 0 & 0\\ 0 & d_{22} & 0\\ 0 & 0 & d_{33} \end{pmatrix} \begin{pmatrix} 1 & l_{21} & l_{31}\\ 0 & 1 & l_{32}\\ 0 & 0 & 1 \end{pmatrix}\]2.7 Cholesky Decomposition
对于对称正定矩阵 \(\mathbf{A}\), 即
\[\mathbf{A} = \mathbf{A}^{\mathsf{T}},\qquad \mathbf{x}^{\mathsf{T}}\mathbf{A}\mathbf{x} >0,\qquad \forall \mathbf{x}\neq\mathbf{0}\]Cholesky 分解 利用下三角矩阵 \(\mathbf{L}\) 分解
\[\mathbf{A}=\mathbf{L}\mathbf{L}^{\mathsf{T}}\]Example 三维 Cholesky 分解.
Solution 考虑
\[\mathbf{L}\mathbf{L}^{\mathsf{T}} = \begin{pmatrix} l_{11} & 0 & 0\\ l_{21} & l_{22} & 0\\ l_{31} & l_{32} & l_{33} \end{pmatrix} \begin{pmatrix} l_{11} & l_{21} & l_{31}\\ 0 & l_{22} & l_{32}\\ 0 & 0 & l_{33} \end{pmatrix} = \begin{pmatrix} l_{11}^2 & l_{11}l_{21} & l_{11}l_{31}\\ l_{11}l_{21} & l_{21}^2+l_{22}^2 & l_{21}l_{31}+l_{22}l_{32}\\ l_{11}l_{31} & l_{21}l_{31}+l_{22}l_{32} & l_{31}^2+l_{32}^2+l_{33}^2 \end{pmatrix}\]第一列:
\[l_{11} = \sqrt{a_{11}},\qquad l_{i1} = \frac{a_{i1}}{l_{11}},\qquad i=2,3,\cdots,n.\]第 \(m\) 列:
\[\begin{aligned} \sum_{k=1}^{m}l_{mk}^2 &= a_{mm} \implies l_{mm}=\sqrt{a_{mm}-\sum_{k=1}^{m-1}l_{mk}^2},\\ \sum_{k=1}^{m}l_{ik}l_{mk} &= a_{im} \implies l_{im}=\frac{1}{l_{mm}}\left(a_{im}-\sum_{k=1}^{m-1}l_{ik}l_{mk}\right),\\ &\qquad i=m+1,m+2,\cdots,n. \end{aligned}\]
2.8 Jacobi Iteration
Jacobi 迭代是求解线性方程组 \(\mathbf{A}\mathbf{x}=\mathbf{b}\) 的一种迭代方法.
Notation 把矩阵拆成对角部分和非对角部分. 记
\[\mathbf{A}=\mathbf{D}+\mathbf{L}+\mathbf{U},\]其中 \(\mathbf{D}\) 是对角部分, \(\mathbf{L}\) 是严格下三角部分, \(\mathbf{U}\) 是严格上三角部分:
\[D_{ij}=a_{ij}\delta_{ij}, \qquad L_{ij}= \begin{cases} a_{ij}, & i>j,\\ 0, & i\leq j, \end{cases} \qquad U_{ij}= \begin{cases} a_{ij}, & i\lt j,\\ 0, & i\geq j. \end{cases}\]- 要求对角元非零.
- 对迭代矩阵 \(\mathbf{B}_J=-\mathbf{D}^{-1}(\mathbf{L}+\mathbf{U})\), 误差满足 \(\mathbf{e}^{(k)}=\mathbf{B}_J^k\mathbf{e}^{(0)}\). 因而对任意初值收敛等价于谱半径 \(\rho(\mathbf{B}_J)\lt 1\); 严格行对角占优给出 \(\|\mathbf{B}_J\|_\infty\lt 1\), 是一个易检验的充分条件. 对称正定本身并不保证 Jacobi 收敛.
- 下述相邻迭代差只是停止指标, 还应检查残差 \(\|\mathbf{b}-\mathbf{A}\mathbf{x}\|\le\mathrm{atol}+\mathrm{rtol}\|\mathbf{b}\|\), 并设置最大迭代次数.
把线性方程组的第 \(i\) 个方程写作
\[a_{i1}x_1+a_{i2}x_2+\cdots+a_{ii}x_i+\cdots+a_{in}x_n = b_i \implies x_i = \frac{1}{a_{ii}}\left(b_i-\sum_{j=1,\,j\neq i}^{n}a_{ij}x_j\right).\]代入一组初始值(例如 \((0,0,0,\cdots,0)\)), 得到第一轮迭代的结果. 继续迭代, 直到满足某个收敛条件为止. 递推关系为
\[x_i^{(k)}=\frac{1}{a_{ii}}\left(b_i-\sum_{j=1,\,j\neq i}^{n}a_{ij}x_j^{(k-1)}\right),\qquad i=1,2,\cdots,n.\]相邻迭代差的停止指标(例), 仅在 \(\|\mathbf{x}^{(k)}\|_\infty\neq0\) 时使用:
\[\frac{\|\mathbf{x}^{(k)}-\mathbf{x}^{(k-1)}\|_{\infty}}{\|\mathbf{x}^{(k)}\|_{\infty}}\lt 10^{-3}\]
从而
\[\mathbf{A}\mathbf{x}=\mathbf{b} \implies \mathbf{x} =\mathbf{D}^{-1}\mathbf{b} -\mathbf{D}^{-1}(\mathbf{L}+\mathbf{U})\mathbf{x}.\]迭代关系的矩阵形式为
\[\mathbf{x}^{(k)} = \mathbf{D}^{-1}\mathbf{b} - \mathbf{D}^{-1}(\mathbf{L}+\mathbf{U})\mathbf{x}^{(k-1)}\]2.9 Steepest Descent Method
最速下降法是求解线性方程组 \(\mathbf{A} \mathbf{x}=\mathbf{b}\) 的一种迭代方法, 适用于系数矩阵 \(\mathbf{A}\) 为对称正定矩阵的情况. 它的思路是把求解线性方程组转化为求解一个二次函数的最小值问题.
定义二次函数
\[g(\mathbf{x})=\frac{1}{2}\mathbf{x}^{\mathsf{T}}\mathbf{A}\mathbf{x}-\mathbf{b}^{\mathsf{T}}\mathbf{x}\]梯度 \(\nabla g(\mathbf{x})=\mathbf{A}\mathbf{x}-\mathbf{b}\). \(\nabla g=0\) 的位置即为原本方程组的解.
考虑寻找最小值. 给定 \(\mathbf{x}^{(0)}\), 若初始残差 \(\mathbf{b}-\mathbf{A}\mathbf{x}^{(0)}=0\), 则已得到解; 否则最速下降法取 \(\mathbf{v}^{(1)}=\mathbf{b}-\mathbf{A}\mathbf{x}^{(0)}\), 并在每步使用新的非零残差作为方向.
考虑沿试探方向的移动
\[g(\mathbf{x}+t\mathbf{v}) = g(\mathbf{x})-t\langle \mathbf{b}-\mathbf{A}\mathbf{x},\mathbf{v}\rangle +\frac{1}{2}t^2\langle \mathbf{v},\mathbf{A}\mathbf{v}\rangle.\]其中内积 \(\langle \mathbf{b}-\mathbf{A}\mathbf{x},\mathbf{v}\rangle=\mathbf{b}^{\mathsf{T}}\mathbf{v}-\mathbf{x}^{\mathsf{T}}\mathbf{A}\mathbf{v}\).
上式看作一个关于步长 \(t\) 的二次函数, 其最小值点为
\[\hat{t}=\frac{\langle \mathbf{b}-\mathbf{A}\mathbf{x},\mathbf{v}\rangle}{\langle \mathbf{v},\mathbf{A}\mathbf{v}\rangle}\]当 \(\langle\mathbf{b}-\mathbf{A}\mathbf{x},\mathbf{v}\rangle\neq0\) 时严格降低函数值; 若该内积为零, 最优步长为零, 不能仅由 \(\mathbf{v}\neq0\) 推出严格下降.
再进行迭代:
\[t_k=\frac{\langle \mathbf{v}^{(k)},\mathbf{b}-\mathbf{A}\mathbf{x}^{(k-1)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle}, \qquad \mathbf{x}^{(k)}=\mathbf{x}^{(k-1)}+t_k\mathbf{v}^{(k)}\]可以用残差来定义新方向:
\[\mathbf{v}^{(k+1)}=\mathbf{b}-\mathbf{A}\mathbf{x}^{(k)}\]
2.10 Conjugate Gradient Method
前面的最速下降法每次迭代的方向都是残差的方向, 可能会出现振荡的情况.
共轭梯度法的搜索方向不仅依赖于残差的方向, 还依赖于上一次迭代的搜索方向, 最终使得每次迭代的搜索方向都是共轭的.
Definition A-共轭: 对于非零向量 \(\mathbf{v}\) 和 \(\mathbf{w}\), 如果满足
\[\langle \mathbf{v},\mathbf{A}\mathbf{w}\rangle=0\]则称 \(\mathbf{v}\) 和 \(\mathbf{w}\) 是 A-共轭的.
共轭梯度法 要求满足
这里假设 \(\mathbf{A}\) 为实对称正定矩阵, 初始方向为残差. 下列正交与共轭关系在精确算术中成立, 从而最多 \(n\) 步求解 \(n\) 维问题; 浮点舍入会破坏这些关系, 应以实际残差验收. 非正定矩阵不能直接使用此处的算法保证.
共轭
\[\langle \mathbf{v}^{(i)},\mathbf{A}\mathbf{v}^{(j)}\rangle=0,\qquad i\neq j.\]残差正交
\[\langle \mathbf{r}^{(i)},\mathbf{r}^{(j)}\rangle=0,\qquad i\neq j.\]残差与旧方向正交
\[\langle \mathbf{r}^{(k)},\mathbf{v}^{(j)}\rangle=0,\qquad j=1,2,\cdots,k.\]
递推公式为
\[\mathbf{v}^{(k+1)}=\mathbf{r}^{(k)}+s_k\mathbf{v}^{(k)}\]由共轭条件 \(\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k+1)}\rangle=0\), 得到
\[\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{r}^{(k)}\rangle +s_k\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle = 0\]解得
\[s_k=-\frac{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{r}^{(k)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle}\]再选择合适的步长 \(t_{k}\) 以保证残差条件 \(\langle \mathbf{r}^{(i)}, \mathbf{r}^{(j)} \rangle = 0\). 利用最速下降法的结果
\[\begin{aligned} t_k &=\frac{\langle \mathbf{v}^{(k)},\mathbf{r}^{(k-1)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle} =\frac{\langle \mathbf{r}^{(k-1)},\mathbf{r}^{(k-1)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle} +s_{k-1}\frac{\langle \mathbf{v}^{(k-1)},\mathbf{r}^{(k-1)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle}\\ &=\frac{\langle \mathbf{r}^{(k-1)},\mathbf{r}^{(k-1)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle}. \end{aligned}\]已知
\[\mathbf{r}^{(k)} =\mathbf{r}^{(k-1)}-\mathbf{A}\left(\mathbf{x}^{(k)}-\mathbf{x}^{(k-1)}\right) =\mathbf{r}^{(k-1)}-t_k\mathbf{A}\mathbf{v}^{(k)}\]从而
\[\langle \mathbf{r}^{(k)},\mathbf{r}^{(k)}\rangle =\langle \mathbf{r}^{(k-1)},\mathbf{r}^{(k)}\rangle -t_k\langle \mathbf{A}\mathbf{v}^{(k)},\mathbf{r}^{(k)}\rangle =-t_k\langle \mathbf{A}\mathbf{v}^{(k)},\mathbf{r}^{(k)}\rangle,\]故可以用残差写
\[s_k =\frac{\langle \mathbf{r}^{(k)},\mathbf{r}^{(k)}\rangle}{\langle \mathbf{r}^{(k-1)},\mathbf{r}^{(k-1)}\rangle}, \qquad t_k =\frac{\langle \mathbf{v}^{(k)},\mathbf{r}^{(k-1)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle}\]最终按顺序的递推关系为
\[\begin{aligned} t_k &=\frac{\langle \mathbf{v}^{(k)},\mathbf{r}^{(k-1)}\rangle}{\langle \mathbf{v}^{(k)},\mathbf{A}\mathbf{v}^{(k)}\rangle}\\ \mathbf{x}^{(k)} &= \mathbf{x}^{(k-1)}+t_k\mathbf{v}^{(k)},\\ \mathbf{r}^{(k)} &= \mathbf{r}^{(k-1)}-t_k\mathbf{A}\mathbf{v}^{(k)},\\ s_k &=\frac{\langle \mathbf{r}^{(k)},\mathbf{r}^{(k)}\rangle}{\langle \mathbf{r}^{(k-1)},\mathbf{r}^{(k-1)}\rangle}\\ \mathbf{v}^{(k+1)} &= \mathbf{r}^{(k)}+s_k\mathbf{v}^{(k)}. \end{aligned}\]初值 \(\mathbf{r}^{(0)}=\mathbf{b}-\mathbf{A}\mathbf{x}^{(0)},\mathbf{v}^{(1)}=\mathbf{r}^{(0)}\). 初始或更新后的残差为零时立即停止, 不再计算下一个步长; 浮点计算按相对及绝对残差容限和最大迭代次数停止.4
Example 考虑线性方程组两步共轭梯度法
\[\begin{pmatrix} 4 & 1\\ 1 & 3 \end{pmatrix} \begin{pmatrix} x_1\\ x_2 \end{pmatrix} = \begin{pmatrix} 1\\ 2 \end{pmatrix}\]Solution 先初始化, 设 \(\mathbf{x}_0=(2,1)^{\mathsf{T}}\).
初始化. 残差:
\[\mathbf{r}_0=\mathbf{b}-\mathbf{A}\mathbf{x}_0 = \binom{1}{2} - \begin{pmatrix} 4 & 1\\ 1 & 3 \end{pmatrix} \binom{2}{1} = \binom{-8}{-3}\]搜索方向:
\[\mathbf{v}_1=\mathbf{r}_0=\binom{-8}{-3}\]第一步. 步长:
\[t_1=\frac{\langle \mathbf{v}_1,\mathbf{r}_0\rangle}{\langle \mathbf{v}_1,\mathbf{A}\mathbf{v}_1\rangle}=\frac{73}{331}\]更新解:
\[\mathbf{x}_1=\binom{2}{1}+\frac{73}{331}\binom{-8}{-3}=\binom{78/331}{112/331}\approx\binom{0.2356}{0.3384}\]残差:
\[\mathbf{r}_1=\mathbf{r}_0-t_1\mathbf{A}\mathbf{v}_1 = \binom{-8}{-3} -\frac{73}{331} \begin{pmatrix} 4 & 1\\ 1 & 3 \end{pmatrix} \binom{-8}{-3} =\binom{-93/331}{248/331} \approx\binom{-0.2810}{0.7492}\]系数:
\[s_1=\frac{\langle \mathbf{r}^{(1)},\mathbf{r}^{(1)}\rangle}{\langle \mathbf{r}^{(0)},\mathbf{r}^{(0)}\rangle}=\frac{961}{109561}\approx0.0088\]搜索方向:
\[\mathbf{v}_2=\mathbf{r}_1+s_1\mathbf{v}_1 = \binom{-93/331}{248/331} +\frac{961}{109561}\binom{-8}{-3} =\binom{-38471/109561}{79205/109561} \approx\binom{-0.3511}{0.7229}\]第二步. 步长:
\[t_2=\frac{\langle \mathbf{v}_2,\mathbf{r}_1\rangle}{\langle \mathbf{v}_2,\mathbf{A}\mathbf{v}_2\rangle}=\frac{331}{803}\approx0.4122\]更新解:
\[\mathbf{x}_2 =\binom{78/331}{112/331} +\frac{331}{803}\binom{-38471/109561}{79205/109561} =\binom{1/11}{7/11} \approx\binom{0.0909}{0.6364}\]
2.11 QR Decomposition
QR 分解法
\[\mathbf{A}=\mathbf{Q}\mathbf{R}\]其中 \(\mathbf{Q}\) 为正交矩阵, \(\mathbf{R}\) 为上三角矩阵. 于是线性方程组可以写作
\[\mathbf{A}\mathbf{x}=\mathbf{b}\implies \mathbf{R}\mathbf{x}=\mathbf{Q}^{\mathsf{T}}\mathbf{b}\]以下解方程的公式针对实非奇异方阵. 对一般 \(m\times n\) 实列满秩矩阵 \((m\geq n)\), 可用薄 QR 分解, 其中 \(\mathbf{Q}^{\mathsf{T}}\mathbf{Q}=\mathbf{I}_n\), 但矩形 \(\mathbf{Q}\) 不是方阵正交矩阵. 若方程不相容, \(\mathbf{R}\mathbf{x}=\mathbf{Q}^{\mathsf{T}}\mathbf{b}\) 给出最小二乘解. 下面的逐列归一化要求列向量线性无关; 浮点实现通常选用 Householder 或 modified Gram-Schmidt 来改善正交性保持.
Gram-Schmidt 正交化 对一组列向量
\[\mathbf{a}_1,\mathbf{a}_2,\cdots,\mathbf{a}_n\]可以将矩阵列向量组 (\(\mathbf{a}_1, \mathbf{a}_2, \cdots, \mathbf{a}_n\)) 变换成正交列向量组 (\(\mathbf{u}_1, \mathbf{u}_2, \cdots, \mathbf{u}_n\)).
\[\begin{aligned} &\mathbf{u}_1=\mathbf{a}_1, &&\mathbf{e}_1=\frac{\mathbf{u}_1}{\|\mathbf{u}_1\|},\\ &\mathbf{u}_2=\mathbf{a}_2-\langle \mathbf{a}_2,\mathbf{e}_1\rangle\mathbf{e}_1, &&\mathbf{e}_2=\frac{\mathbf{u}_2}{\|\mathbf{u}_2\|},\\ &\mathbf{u}_n=\mathbf{a}_n-\sum_{j=1}^{n-1}\langle \mathbf{a}_n,\mathbf{e}_j\rangle\mathbf{e}_j, &&\mathbf{e}_n=\frac{\mathbf{u}_n}{\|\mathbf{u}_n\|}. \end{aligned}\]故如果视
\[\mathbf{A}=(\mathbf{a}_1,\mathbf{a}_2,\cdots,\mathbf{a}_n), \qquad \mathbf{Q}=(\mathbf{e}_1,\mathbf{e}_2,\cdots,\mathbf{e}_n)\]从而 \(\mathbf{A}\) 的列向量在 \(\mathbf{Q}\) 给出的正交基下的展开可以写为矩阵形式
\[\begin{aligned} \mathbf{a}_k &= \sum_{j=1}^{k}\langle \mathbf{a}_k,\mathbf{e}_j\rangle\mathbf{e}_j \implies \mathbf{A} =(\mathbf{e}_1,\mathbf{e}_2,\cdots,\mathbf{e}_n)\mathbf{R}=\mathbf{Q}\mathbf{R}\\ \mathbf{R} &= \begin{pmatrix} \langle \mathbf{a}_1,\mathbf{e}_1\rangle & \langle \mathbf{a}_2,\mathbf{e}_1\rangle & \cdots & \langle \mathbf{a}_n,\mathbf{e}_1\rangle\\ 0 & \langle \mathbf{a}_2,\mathbf{e}_2\rangle & \cdots & \langle \mathbf{a}_n,\mathbf{e}_2\rangle\\ \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & \cdots & \langle \mathbf{a}_n,\mathbf{e}_n\rangle \end{pmatrix} \end{aligned}\]Example 对矩阵作 QR 分解
\[\mathbf{A} = \begin{pmatrix} 1 & 1 & 0\\ 1 & 0 & 1\\ 0 & 1 & 1 \end{pmatrix}.\]Solution 记 \(\mathbf{A}=(\mathbf{a}_1,\mathbf{a}_2,\mathbf{a}_3)\). Gram-Schmidt 正交化给出
\[\begin{aligned} \mathbf{u}_1&=\mathbf{a}_1=(1,1,0)^{\mathsf{T}},\\ \mathbf{e}_1&=\frac{\mathbf{u}_1}{\|\mathbf{u}_1\|}=\frac{1}{\sqrt{2}}(1,1,0)^{\mathsf{T}},\\ \mathbf{u}_2&=\mathbf{a}_2-\langle \mathbf{a}_2,\mathbf{e}_1\rangle\mathbf{e}_1 =\left(\frac{1}{2},-\frac{1}{2},1\right)^{\mathsf{T}},\\ \mathbf{e}_2&=\frac{1}{\sqrt{6}}(1,-1,2)^{\mathsf{T}},\\ \mathbf{u}_3&=\mathbf{a}_3-\langle \mathbf{a}_3,\mathbf{e}_1\rangle\mathbf{e}_1-\langle \mathbf{a}_3,\mathbf{e}_2\rangle\mathbf{e}_2 =\frac{2}{3}(-1,1,1)^{\mathsf{T}},\\ \mathbf{e}_3&=\frac{1}{\sqrt{3}}(-1,1,1)^{\mathsf{T}}. \end{aligned}\]得到
\[\mathbf{Q} = \begin{pmatrix} \frac{1}{\sqrt{2}} & \frac{1}{\sqrt{6}} & -\frac{1}{\sqrt{3}}\\ \frac{1}{\sqrt{2}} & -\frac{1}{\sqrt{6}} & \frac{1}{\sqrt{3}}\\ 0 & \frac{2}{\sqrt{6}} & \frac{1}{\sqrt{3}} \end{pmatrix}, \qquad \mathbf{R} = \begin{pmatrix} \sqrt{2} & \frac{1}{\sqrt{2}} & \frac{1}{\sqrt{2}}\\ 0 & \frac{\sqrt{6}}{2} & \frac{1}{\sqrt{6}}\\ 0 & 0 & \frac{2}{\sqrt{3}} \end{pmatrix}.\]2.12 SVD Decomposition *
任意 \(m\times n\) 实矩阵 \(\mathbf{A}\) 均可作 SVD(singular value decomposition):5
\[\mathbf{A}=\mathbf{U}\mathbf{D}\mathbf{V}^{\mathsf{T}}\]其中 \(\mathbf{U}\) 为 \(m \times m\) 正交矩阵, \(\mathbf{V}\) 为 \(n \times n\) 正交矩阵, \(\mathbf{D}\) 为 \(m \times n\) 对角矩阵, 对角线上的元素为 \(\mathbf{A}\) 的奇异值 \(\sigma_i\). 可以将 \(\mathbf{U}\) 的列向量称为左奇异向量, \(\mathbf{V}\) 的列向量称为右奇异向量.
\[\begin{aligned} \mathbf{U}\mathbf{U}^{\mathsf{T}}&=\mathbf{I}_m,\qquad \mathbf{V}\mathbf{V}^{\mathsf{T}}=\mathbf{I}_n,\\ D_{ij}&= \begin{cases} \sigma_i\delta_{ij}, & i\leq r,\\ 0, & i>r, \end{cases} \qquad r=\min(m,n),\qquad \sigma_1\geq\cdots\geq\sigma_r\geq0. \end{aligned}\]仅当 \(m=n\) 且所有奇异值非零时, 普通逆矩阵为
\[\mathbf{A}^{-1}=\mathbf{V}\mathbf{D}^{-1}\mathbf{U}^{\mathsf{T}}.\]一般矩形或秩亏矩阵使用 Moore-Penrose 伪逆 \(\mathbf{A}^{+}=\mathbf{V}\mathbf{D}^{+}\mathbf{U}^{\mathsf{T}}\). 其中 \(\mathbf{D}^{+}\) 为 \(n\times m\) 矩阵, 非零奇异值取倒数, 零奇异值仍取零; \(\mathbf{x}=\mathbf{A}^{+}\mathbf{b}\) 给出最小范数的最小二乘解.6
为抑制小奇异值对噪声的放大, 可作截断 SVD 正则化, 令 \(\epsilon\geq0\), 并定义
\[\begin{aligned} \mathbf{A}_{\epsilon}^{+}&=\mathbf{V}\mathbf{D}_{\epsilon}^{+}\mathbf{U}^{\mathsf{T}},\\ \left(\mathbf{D}_{\epsilon}^{+}\right)_{ii}&= \begin{cases} 1/\sigma_i, & \sigma_i>\epsilon,\\ 0, & \sigma_i\leq\epsilon, \end{cases} \qquad i=1,\cdots,r, \end{aligned}\]其他元素为零. 阈值常相对最大奇异值设置; 截断改变了所求问题, 并不保证消除噪声, 也不能把含零奇异值的 \(\mathbf{D}_{\epsilon}\) 当成可逆矩阵.
2.13 Sherman-Morrison Formula *
Sherman-Morrison 公式提供了一种计算矩阵的逆的方法.
设 \(\mathbf{A}\) 为一个可逆矩阵, \(\mathbf{u}\) 和 \(\mathbf{v}\) 为同维列向量, 考虑矩阵
\[\mathbf{B}=\mathbf{A}+\mathbf{u}\mathbf{v}^{\mathsf{T}}\]的逆矩阵. 以下要求 \(1+\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1}\mathbf{u}\neq0\), 等价于更新后的 \(\mathbf{B}\) 仍可逆. 这是秩不超过 1 的更新.
\[\begin{aligned} \left(\mathbf{u}\mathbf{v}^{\mathsf{T}}\right)_{ij} &= u_i v_j,\\ \left(\mathbf{A}+\mathbf{u}\mathbf{v}^{\mathsf{T}}\right)^{-1} &=\left(\mathbf{I}+\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}\right)^{-1}\mathbf{A}^{-1}. \end{aligned}\]先考虑 Neumann 级数展开, 要求 \(\rho(\mathbf{M})\lt1\). 对下式的秩-1 矩阵, 收敛条件为 \(|\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1}\mathbf{u}|\lt1\):
\[\begin{aligned} (\mathbf{I}-\mathbf{M})^{-1} &=\mathbf{I}+\mathbf{M}+\mathbf{M}^2+\mathbf{M}^3+\cdots,\\ \left(\mathbf{I}+\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}\right)^{-1} &=\mathbf{I}-\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}} +\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}-\cdots. \end{aligned}\]定义
\[\lambda=\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1}\mathbf{u}.\]在 \(|\lambda|\lt1\) 时, 上述级数求和给出
\[\begin{aligned} \left(\mathbf{A}+\mathbf{u}\mathbf{v}^{\mathsf{T}}\right)^{-1} &=\mathbf{A}^{-1}-\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1} \left(1-\lambda+\lambda^2-\cdots\right)\\ &=\mathbf{A}^{-1}-\frac{\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1}}{1+\lambda},\\ \left(\mathbf{A}+\mathbf{u}\mathbf{v}^{\mathsf{T}}\right)^{-1} &=\mathbf{A}^{-1}-\frac{\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1}}{1+\mathbf{v}^{\mathsf{T}}\mathbf{A}^{-1}\mathbf{u}}. \end{aligned}\]结果其实只需 \(1+\lambda\neq0\). 令 \(\mathbf{M}=\mathbf{A}^{-1}\mathbf{u}\mathbf{v}^{\mathsf{T}}\), 则 \(\mathbf{M}^2=\lambda\mathbf{M}\), 可以直接验证
\[(\mathbf{I}+\mathbf{M})\left(\mathbf{I}-\frac{\mathbf{M}}{1+\lambda}\right) =\mathbf{I}+\mathbf{M}-\frac{\mathbf{M}+\mathbf{M}^2}{1+\lambda}=\mathbf{I}.\]因此 Sherman-Morrison 公式在级数不收敛但分母非零时仍成立. 考虑方程组:
\[\left(\mathbf{A}+\mathbf{u}\mathbf{v}^{\mathsf{T}}\right)\mathbf{x}=\mathbf{b}\]已知方程组的解:
\[\begin{aligned} \mathbf{A}\mathbf{y}&=\mathbf{b},\\ \mathbf{A}\mathbf{z}&=\mathbf{u}. \end{aligned}\]方程的解为:
\[\mathbf{x}=\mathbf{y}-\frac{\mathbf{v}^{\mathsf{T}}\mathbf{y}}{1+\mathbf{v}^{\mathsf{T}}\mathbf{z}}\mathbf{z}\]Appendix
A.1 Scientific Computing Environment
GNU/Linux
GNU/Linux 提供类 Unix 开发环境, 可作为科学计算的工作平台.
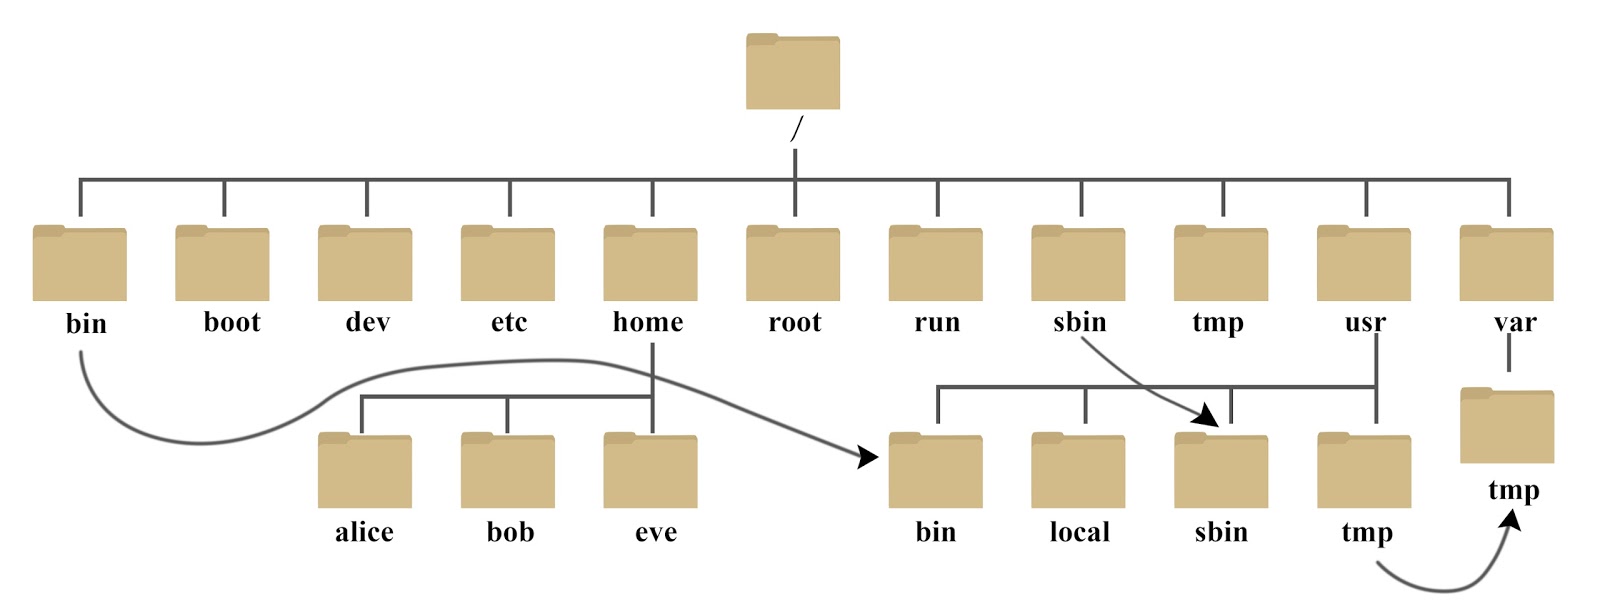
GNU/Linux 文件系统层级的简化示例, 不是完整目录清单. 实际目录、挂载点和符号链接随发行版与配置而变; 目录用途可对照 Filesystem Hierarchy Standard 3.0.
Ubuntu 基于 Debian; amd64(x86-64)、arm64(AArch64) 和 ppc64el(PowerPC64 little-endian) 属于不同架构, arm64 不属于 PowerPC. 具体支持范围取决于发行版本.7
Shared Toolchain
- Linux 的静态库以
.a为后缀, 由一系列目标文件组成, 在编译时被链接到可执行文件中. Windows 的静态库以.lib为后缀. - Linux 的动态库以
.so为后缀, 在运行时被加载到内存中, 可以被多个程序共享使用. Windows 的动态库以.dll为后缀. - C++ 适合高性能实现, 数据结构组织和大型工程; Fortran 仍常见于传统科学计算程序; Python 适合原型设计, 数据处理, 可视化和脚本化实验流程.
- NumPy 是 Python 科学计算的基础数组库; CERN ROOT 是高能物理中常见的数据分析框架; 现代工作流中优先使用
git追踪代码与结果.
References
- W. H. Press, S. A. Teukolsky, W. T. Vetterling, B. P. Flannery, Numerical Recipes in C++.
Oracle, Numerical Computation Guide, 2.2.2 Single Format, Tables 2-2 and 2-3. ↩︎
Oracle, Numerical Computation Guide, 2.2.3 Double Format, Tables 2-4 and 2-5. ↩︎
LAPACK Authors, LAPACK Users’ Guide, How to Measure Errors, vector and matrix norms, and condition numbers. ↩︎
J. R. Shewchuk, An Introduction to the Conjugate Gradient Method Without the Agonizing Pain, Sections 8, 11 and 12. ↩︎
NumPy Developers, numpy.linalg.svd, full and reduced SVD dimensions. ↩︎
NumPy Developers, numpy.linalg.pinv, Moore-Penrose inverse and singular-value cutoff. ↩︎
Ubuntu Project, Supported architectures. ↩︎