Computational Physics - 3
计算物理笔记(三)
On this page
7 Eigenvalue Problems
在解决实际物理问题的过程中, 经常需要求解矩阵的本征值和本征向量, 例如在量子力学中, 哈密顿算符的本征值对应系统的能量, 而本征向量则对应系统的状态. 本征值问题可以写作
\[\mathbf{A} \mathbf{x} = \lambda \mathbf{x}\]\[\begin{aligned} a_{11}x_{1}+a_{12}x_{2}+\cdots+a_{1n}x_{n} &= \lambda x_{1},\\ a_{21}x_{1}+a_{22}x_{2}+\cdots+a_{2n}x_{n} &= \lambda x_{2},\\ &\vdots\\ a_{n1}x_1+a_{n2}x_2+\cdots+a_{nn}x_n &= \lambda x_n, \end{aligned}\]\[\Longrightarrow (\mathbf{A} - \lambda \mathbf{I}) \mathbf{x} = 0\]即要求行列式:
\[\det(\mathbf{A} - \lambda \mathbf{I}) = 0\]求出方程的根, 得到本征值
\[\lambda_1, \lambda_2, \cdots, \lambda_n\]每个本征值对应一个或多个线性无关的本征向量.
本征值满足关系:
\[\begin{aligned} \lambda_1 + \lambda_2 + \cdots + \lambda_n &= \operatorname{tr}(\mathbf{A}),\\ \lambda_1 \lambda_2 \cdots \lambda_n &= \det(\mathbf{A}). \end{aligned}\]实对称矩阵正交相似于对角矩阵, 即存在一个正交矩阵 \(\mathbf{S}\) 使得
\[\mathbf{S}^{\mathsf{T}} \mathbf{A} \mathbf{S} = \operatorname{diag}(\lambda_1, \lambda_2, \cdots, \lambda_n)\]其中 \(\mathbf{S}\) 为正交矩阵, 它就是由 \(\mathbf{A}\) 的本征向量组成的矩阵. 对于实对称矩阵, 所有的本征值都是实数, 并且对应的本征向量可以选择为相互正交的. \(\lambda_{1}, \lambda_{2}, \cdots, \lambda_{n}\) 即为 \(\mathbf{A}\) 的本征值.
7.1 Jacobi Method
Jacobi 方法是求解实对称矩阵本征值问题的经典算法. 它通过一系列的旋转操作来逐步将矩阵对角化. 其中每一次旋转可以看作是一个二维平面内的旋转, 目的是消除矩阵中的一对非对角元素.
旋转矩阵:
\[\mathbf{S}= \begin{pmatrix} 1 & 0 & \cdots & 0 & \cdots & 0 & \cdots & 0\\ 0 & 1 & \cdots & 0 & \cdots & 0 & \cdots & 0\\ \vdots & \vdots & \ddots & \vdots & \cdots & \vdots & \cdots & \vdots\\ 0 & 0 & \cdots & \cos\theta & \cdots & \sin\theta & \cdots & 0\\ \vdots & \vdots & \cdots & \vdots & \ddots & \vdots & \cdots & \vdots\\ 0 & 0 & \cdots & -\sin\theta & \cdots & \cos\theta & \cdots & 0\\ \vdots & \vdots & \cdots & \vdots & \cdots & \vdots & \ddots & \vdots\\ 0 & 0 & \cdots & 0 & \cdots & 0 & \cdots & 1 \end{pmatrix}\]可以看到
\[\begin{aligned} s_{kk} &= s_{ll} = \cos\theta,\\ s_{kl} &= -s_{lk} = \sin\theta,\\ s_{ii} &= 1,\quad i \neq k,l,\\ s_{ij} &= 0,\quad i \neq j,\quad (i,j)\notin\{(k,l),(l,k)\}. \end{aligned}\]其中 \(\theta\) 为旋转角度, 旋转作用于第 \(k\) 行和第 \(l\) 行. 通过选择合适的 \(\theta\), 可以将矩阵 \(\mathbf{A}\) 中的第 \(k\) 行第 \(l\) 列的元素消除为零. 下面来计算这个合适的角度 \(\theta\).
考虑矩阵
\[\mathbf{B} = \mathbf{S}^{\mathsf{T}} \mathbf{A} \mathbf{S}\]矩阵 \(\mathbf{B}\) 的第 \(i\) 行第 \(j\) 列元素为
\[\begin{aligned} b_{ii} &= a_{ii},\quad i \neq k,l,\\ b_{ik} &= a_{ik}\cos\theta - a_{il}\sin\theta,\quad i \neq k,l,\\ b_{il} &= a_{il}\cos\theta + a_{ik}\sin\theta,\quad i \neq k,l,\\ b_{kk} &= a_{kk}\cos^2\theta + a_{ll}\sin^2\theta - 2a_{kl}\sin\theta\cos\theta,\\ b_{ll} &= a_{ll}\cos^2\theta + a_{kk}\sin^2\theta + 2a_{kl}\sin\theta\cos\theta,\\ b_{kl} &= (a_{kk} - a_{ll})\sin\theta\cos\theta + a_{kl}(\cos^2\theta - \sin^2\theta). \end{aligned}\]要消除第 \(k\) 行第 \(l\) 列的元素, 即 \(b_{kl}=0\), 可以得到
\[\tan 2\theta = \frac{2a_{kl}}{a_{ll} - a_{kk}}\]当 \(a_{kk}=a_{ll}\) 且 \(a_{kl}\neq0\) 时, 可取 \(\theta=\pi/4\); 若 \(a_{kl}=0\), 则无需旋转. 通过不断选择当前矩阵中绝对值最大的非对角元素进行旋转, 可以逐步将矩阵对角化, 最终得到其本征值.
7.2 Householder Transformation
对于实对称矩阵 \(\mathbf{A}\), 存在相似变换:
\[\mathbf{S}_1^{\mathsf{T}} \mathbf{A} \mathbf{S}_1 = \begin{pmatrix} a_{11} & e_1 & 0 & \cdots & 0\\ e_1 & a'_{22} & a'_{23} & \cdots & a'_{n2}\\ 0 & a'_{32} & a'_{33} & \cdots & a'_{n3}\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & a'_{n2} & a'_{n3} & \cdots & a'_{nn} \end{pmatrix}\]即将矩阵 \(\mathbf{A}\) 的第一列(除前两个元素外)消除为零. 以此类推, 最后可以得到一个三对角矩阵:
\[\mathbf{S}^{\mathsf{T}} \mathbf{A} \mathbf{S} = \begin{pmatrix} a_{11} & e_1 & 0 & \cdots & 0\\ e_1 & a'_{22} & e_2 & \cdots & 0\\ 0 & e_2 & a''_{33} & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & a^{(n-1)}_{nn} \end{pmatrix}\]下面按步骤构造 Householder 矩阵 \(\mathbf{S}\) 来实现上述相似变换.
定义 Householder 反射矩阵
\[\mathbf{P} = \mathbf{I} - 2\mathbf{w}\mathbf{w}^{\mathsf{T}}\]其中 \(\mathbf{w}\) 是单位向量 \(\mathbf{w}^{\mathsf{T}}\mathbf{w} = 1\).
构造分块矩阵
\[\mathbf{S}_1 = \begin{pmatrix} 1 & \mathbf{0}^{\mathsf{T}}\\ \mathbf{0} & \mathbf{P} \end{pmatrix}\]对原矩阵 \(\mathbf{A}\) 作相似变换:
\[\mathbf{S}_1^{\mathsf{T}}\mathbf{A}\mathbf{S}_1 = \begin{pmatrix} a_{11} & \mathbf{v}^{\mathsf{T}}\mathbf{P}\\ \mathbf{P}\mathbf{v} & \mathbf{A}' \end{pmatrix}\]其中
\[\mathbf{v} = \left(a_{21}, a_{31}, \cdots, a_{n1}\right)^{\mathsf{T}}.\]若 \(\mathbf{v}=\mathbf{0}\), 该列无需消元, 直接取 \(\mathbf{S}_1=\mathbf{I}\), 跳过本次反射的构造. 以下推导假设 \(\mathbf{v}\neq\mathbf{0}\).
选取 \(\mathbf{w}\), 使 \(\mathbf{v}\) 的后 \(n-2\) 个元素被消去:
\[\mathbf{P}\mathbf{v} = (\alpha, 0, 0, \cdots, 0)^{\mathsf{T}} = \alpha\mathbf{e},\]其中 \(\mathbf{e}=(1,0,0,\cdots,0)^{\mathsf{T}}\), \(\alpha\) 为某个实数.
利用 Householder 反射保持向量范数的性质求 \(\alpha\):
\[(\mathbf{P}\mathbf{v})^{\mathsf{T}}\mathbf{P}\mathbf{v} = \alpha^2 = \mathbf{v}^{\mathsf{T}}\mathbf{v} = \lVert\mathbf{v}\rVert^2 \implies \alpha^2 = \sum_{i=2}^n a_{i1}^2.\]由反射公式反推 \(\mathbf{w}\):
\[\mathbf{P}\mathbf{v} = \mathbf{v} - 2\mathbf{w}(\mathbf{w}^{\mathsf{T}}\mathbf{v}) = \alpha\mathbf{e} \implies \mathbf{v} - \alpha\mathbf{e} = 2\mathbf{w}(\mathbf{w}^{\mathsf{T}}\mathbf{v}).\]因此
\[\mathbf{w} = \frac{\mathbf{v} - \alpha\mathbf{e}}{2\mathbf{w}^{\mathsf{T}}\mathbf{v}}.\]令 \(\beta=\mathbf{w}^{\mathsf{T}}\mathbf{v}\), 求出归一化因子:
\[\beta = \mathbf{w}^{\mathsf{T}}\mathbf{v} = \frac{(\mathbf{v} - \alpha\mathbf{e})^{\mathsf{T}}\mathbf{v}}{2\beta} \implies 2\beta^2 = (\mathbf{v} - \alpha\mathbf{e})^{\mathsf{T}}\mathbf{v}.\]又因为
\[\mathbf{e}^{\mathsf{T}}\mathbf{v} = a_{21}, \qquad \mathbf{v}^{\mathsf{T}}\mathbf{v} = \alpha^2 \implies 2\beta^2 = \alpha^2 - \alpha a_{21} \implies \beta = \pm \sqrt{\frac{\alpha^2 - \alpha a_{21}}{2}}.\]为避免相减消去有效数字, 当 \(a_{21}\geq0\) 时取 \(\alpha=-\|\mathbf{v}\|_2\), 否则取 \(\alpha=\|\mathbf{v}\|_2\). 这样也明确了 \(a_{21}=0\) 时的选择. 由此得到
\[\mathbf{P} = \mathbf{I} - 2\mathbf{w}\mathbf{w}^{\mathsf{T}} \implies \mathbf{P} = \mathbf{I} - 2\frac{(\mathbf{v} - \alpha\mathbf{e})(\mathbf{v} - \alpha\mathbf{e})^{\mathsf{T}}}{(\mathbf{v} - \alpha\mathbf{e})^{\mathsf{T}}(\mathbf{v} - \alpha\mathbf{e})}.\]第一次 Householder 相似变换为
\[\mathbf{A}^{(2)} = \mathbf{S}_1^{\mathsf{T}}\mathbf{A}^{(1)}\mathbf{S}_1.\]
下面按步骤写出第 \(k\) 次 Householder 迭代, 其中 \(k=1,\cdots,n-2\).
在当前矩阵 \(\mathbf{A}^{(k)}\) 中, 计算待消去列的范数:
\[\alpha^2 = \sum_{i=k+1}^n \left(a_{ik}^{(k)}\right)^2.\]若该范数为零, 直接取 \(\mathbf{S}_k=\mathbf{I}\), 令 \(\mathbf{A}^{(k+1)}=\mathbf{A}^{(k)}\), 然后处理下一列; 不计算本步的归一化因子或反射向量. 否则, 当 \(a_{k+1,k}^{(k)}\geq0\) 时取 \(\alpha\) 为负的列范数, 否则取正值.
计算归一化因子
\[\beta = \pm \sqrt{\frac{\alpha^2 - \alpha a_{k+1,k}^{(k)}}{2}}.\]构造向量 \(\mathbf{w}^{(k)}\). 为不改变前面已经消好的列, 令其前 \(k\) 个元素为零, 后续元素与第一次构造相同:
\[\begin{aligned} w_1^{(k)} &= w_2^{(k)} = \cdots = w_k^{(k)} = 0,\\ w_{k+1}^{(k)} &= \frac{a_{k+1,k}^{(k)} - \alpha}{2\beta},\\ w_i^{(k)} &= \frac{a_{ik}^{(k)}}{2\beta},\quad i = k+2, k+3, \cdots, n. \end{aligned}\]定义第 \(k\) 次 Householder 反射矩阵
\[\mathbf{P}^{(k)} = \mathbf{I} - 2\mathbf{w}^{(k)}\left(\mathbf{w}^{(k)}\right)^{\mathsf{T}}\]由于 \(\mathbf{w}^{(k)}\) 已是前 \(k\) 个分量为零的 \(n\) 维向量, \(\mathbf{P}^{(k)}\) 已在前 \(k\) 个坐标上保持不变. 因此直接取相似变换矩阵
\[\mathbf{S}_k = \mathbf{P}^{(k)}.\]施加相似变换并累积所有 Householder 变换:
\[\begin{aligned} \mathbf{A}^{(k+1)} &= \mathbf{S}_k^{\mathsf{T}}\mathbf{A}^{(k)}\mathbf{S}_k\\ &= \mathbf{S}_k^{\mathsf{T}}\mathbf{S}_{k-1}^{\mathsf{T}}\cdots\mathbf{S}_1^{\mathsf{T}}\mathbf{A}\mathbf{S}_1\cdots\mathbf{S}_{k-1}\mathbf{S}_k. \end{aligned}\]
实对称矩阵最终可以化为三对角矩阵;
非对称矩阵可以化为上 Hessenberg 矩阵, 即第一条次对角线以下的元素全为零.
7.3 QR Decomposition
QR 迭代利用正交相似变换求解本征值问题. 对于一个实对称矩阵 \(\mathbf{A}\), 可以进行 QR 分解:
\[\mathbf{A} = \mathbf{Q} \mathbf{R}\]其中 \(\mathbf{Q}\) 是一个正交矩阵, \(\mathbf{R}\) 是一个上三角矩阵. 通过交换 \(\mathbf{Q}\) 和 \(\mathbf{R}\) 的位置, 可以得到一个新的矩阵. 定义
\[\mathbf{A}^{(k+1)} = \mathbf{R}^{(k)}\mathbf{Q}^{(k)}\]于是
\[\mathbf{A}^{(k+1)} = \left(\mathbf{Q}^{(k)}\right)^{\mathsf{T}}\mathbf{A}^{(k)}\mathbf{Q}^{(k)}\]Proposition QR 迭代保持本征值不变.
Proof 因为 \(\mathbf{Q}^{(k)}\) 为正交矩阵, 所以 \(\left(\mathbf{Q}^{(k)}\right)^{\mathsf{T}}=\left(\mathbf{Q}^{(k)}\right)^{-1}\). 由
\[\mathbf{A}^{(k+1)} = \left(\mathbf{Q}^{(k)}\right)^{-1} \mathbf{A}^{(k)} \mathbf{Q}^{(k)}\]可知, \(\mathbf{A}^{(k+1)}\) 与 \(\mathbf{A}^{(k)}\) 相似, 因此本征值不变.
无位移 QR 的收敛需要谱分离和初始子空间的适当条件, 不能仅由相似性保证. 对实对称矩阵, 在收敛时极限为对角矩阵; 若有正负等模本征值, 迭代可能停留在非对角块, 例如 \(\begin{pmatrix}0&1\\1&0\end{pmatrix}\). 一般实非对称矩阵有复共轭本征值时, 实 QR 的目标是含 \(2\times2\) 对角块的实 Schur 形式.
对于实对称矩阵, 通常先将其化为三对角矩阵, 然后再进行 QR 迭代, 这样可以提高效率. 这一步通常采用 Householder 相似变换; Jacobi 旋转本身则提供逐步对角化的另一种算法.
常见旋转/反射方法的作用如下:
- Jacobi 旋转: 针对实对称矩阵的特定非对角元素, 用相似变换逐步对角化.
- Givens 旋转: 更一般的二维旋转, 可用于任何矩阵的 QR 分解, 用来消除指定元素.
- Householder 变换: 通过反射一次消去一列中的多个元素, 也可用于 QR 分解.
旋转矩阵的形式与 Jacobi 旋转是一样的:
\[\mathbf{S}= \begin{pmatrix} 1 & 0 & \cdots & 0 & \cdots & 0 & \cdots & 0\\ 0 & 1 & \cdots & 0 & \cdots & 0 & \cdots & 0\\ \vdots & \vdots & \ddots & \vdots & \cdots & \vdots & \cdots & \vdots\\ 0 & 0 & \cdots & \cos\theta & \cdots & \sin\theta & \cdots & 0\\ \vdots & \vdots & \cdots & \vdots & \ddots & \vdots & \cdots & \vdots\\ 0 & 0 & \cdots & -\sin\theta & \cdots & \cos\theta & \cdots & 0\\ \vdots & \vdots & \cdots & \vdots & \cdots & \vdots & \ddots & \vdots\\ 0 & 0 & \cdots & 0 & \cdots & 0 & \cdots & 1 \end{pmatrix}\]最终使得
\[(\mathbf{S}\mathbf{A})_{ij} = 0\]于是问题又变为如何求解合适的旋转角度 \(\theta\), 这是相对简单的. 我们的旋转目标是:
\[\begin{aligned} \begin{pmatrix} \cos\theta & \sin\theta\\ -\sin\theta & \cos\theta \end{pmatrix} \begin{pmatrix} a_{jj}\\ a_{ij} \end{pmatrix} &= \begin{pmatrix} r\\ 0 \end{pmatrix},\\ r &= \sqrt{a_{ij}^2 + a_{jj}^2}. \end{aligned}\]可以得到
\[\begin{aligned} \tan\theta &= \frac{a_{ij}}{a_{jj}},\\ \sin\theta &= \frac{a_{ij}}{\sqrt{a_{ij}^2+a_{jj}^2}},\\ \cos\theta &= \frac{a_{jj}}{\sqrt{a_{ij}^2+a_{jj}^2}}. \end{aligned}\]若 \(r=0\), 两个待处理分量均为零, 直接取单位旋转; 否则用上述 \(\sin\theta\) 和 \(\cos\theta\) 构造旋转, 不必先计算可能分母为零的 \(\tan\theta\).
Example 考虑矩阵
\[\begin{pmatrix} 3 & 1 & 0\\ 1 & 3 & 1\\ 0 & 1 & 3 \end{pmatrix}\]Solution 构造 Givens 旋转矩阵 \(\mathbf{S}_{1}\), 使得 \((\mathbf{S}_{1}\mathbf{A})_{21}=0\).
\[\begin{aligned} \tan\theta &= \frac{a_{21}}{a_{11}} = \frac{1}{3},\\ \mathbf{S}_1 &= \begin{pmatrix} \frac{3}{\sqrt{10}} & \frac{1}{\sqrt{10}} & 0\\ -\frac{1}{\sqrt{10}} & \frac{3}{\sqrt{10}} & 0\\ 0 & 0 & 1 \end{pmatrix} \end{aligned}\]\[\begin{aligned} \mathbf{A}_2 &= \mathbf{S}_1\mathbf{A}_1\\ &= \begin{pmatrix} \frac{3}{\sqrt{10}} & \frac{1}{\sqrt{10}} & 0\\ -\frac{1}{\sqrt{10}} & \frac{3}{\sqrt{10}} & 0\\ 0 & 0 & 1 \end{pmatrix} \begin{pmatrix} 3 & 1 & 0\\ 1 & 3 & 1\\ 0 & 1 & 3 \end{pmatrix}\\ &= \begin{pmatrix} \sqrt{10} & \frac{3\sqrt{10}}{5} & \frac{\sqrt{10}}{10}\\ 0 & \frac{4\sqrt{10}}{5} & \frac{3\sqrt{10}}{10}\\ 0 & 1 & 3 \end{pmatrix} \end{aligned}\]再把 \((3,2)\) 元素变为 0, 过程同理
\[\mathbf{A}_3 = \mathbf{S}_2\mathbf{A}_2 = \begin{pmatrix} \sqrt{10} & \frac{3\sqrt{10}}{5} & \frac{\sqrt{10}}{10}\\ 0 & 2.7203 & 1.9851\\ 0 & 0 & 2.4412 \end{pmatrix}\]于是可以进行 QR 分解:
\[\mathbf{Q} = \mathbf{S}_1^{\mathsf{T}}\mathbf{S}_2^{\mathsf{T}} = \begin{pmatrix} 0.94868 & -0.29409 & 0.11625\\ 0.31623 & 0.88226 & -0.34874\\ 0 & 0.36761 & 0.92998 \end{pmatrix}\]迭代:
\[\begin{aligned} \mathbf{A}^{(2)} &= \mathbf{R}\mathbf{Q} = \begin{pmatrix} 3.6 & 0.86023 & 0\\ 0.86023 & 3.12973 & 0.89740\\ 0 & 0.89740 & 2.27027 \end{pmatrix},\\ &\cdots\\ \mathbf{A}^{(13)} &= \begin{pmatrix} 4.4139 & 0.01941 & 0\\ 0.01941 & 3.0003 & 0.00095\\ 0 & 0.00095 & 1.5858 \end{pmatrix}. \end{aligned}\]对本例的实对称矩阵, 迭代逐渐趋于对角矩阵. 有限次迭代的对角元只是本征值的近似; 精确本征值为 \(3+\sqrt2,3,3-\sqrt2\), 与 \(\mathbf A^{(13)}\) 的对角元一致到相应精度.
若用 Householder 变换作 QR 分解, 唯一的区别只是左乘矩阵:
\[\mathbf{P}_n\mathbf{P}_{n-1}\cdots\mathbf{P}_1\mathbf{A}\]因为 QR 分解需要把 \(\mathbf{A}\) 化为上三角矩阵而不是上 Hessenberg 矩阵, 所以初始向量 \(\mathbf{v}\) 应包括第一项:
\[\mathbf{v} = (a_{11}, a_{21}, \cdots, a_{n1})^{\mathsf{T}}\]7.4 Shifted QR Decomposition *
标准的 QR 迭代:
\[\begin{aligned} \mathbf{A}^{(k)} &= \mathbf{Q}^{(k)}\mathbf{R}^{(k)},\\ \mathbf{A}^{(k+1)} &= \mathbf{R}^{(k)}\mathbf{Q}^{(k)}. \end{aligned}\]上 Hessenberg 结构可降低每次 QR 迭代的成本, 但本身不保证次对角元全部趋于零. 在可对角化、模有严格间隔且初始子空间适当的情形, 按 \(|\lambda_1|>\cdots>|\lambda_n|\) 排序后, 相邻子空间的渐近收缩因子为
\[b_j \sim \left|\frac{\lambda_{j+1}}{\lambda_j}\right|,\qquad j=1,\cdots,n-1.\]如果两个特征值很接近, 收敛就会很慢, 需要加速. 带位移的 QR 迭代通过引入一个位移参数 \(\sigma\) 来加速收敛: 首先还是先做预处理, 得到上 Hessenberg 矩阵
\[\mathbf{A}_0 = \mathbf{S}_{n-2}^{\mathsf{T}}\cdots\mathbf{S}_1^{\mathsf{T}} \mathbf{A} \mathbf{S}_1\cdots\mathbf{S}_{n-2}\]再进行迭代:
\[\begin{aligned} \mathbf{A}_k-\sigma_k\mathbf{I} &= \mathbf{Q}_k\mathbf{R}_k,\\ \mathbf{A}_{k+1} &= \mathbf{R}_k\mathbf{Q}_k+\sigma_k\mathbf{I}. \end{aligned}\]对固定的位移 \(\sigma\), 按移后模 \(|\lambda_1-\sigma|>\cdots>|\lambda_n-\sigma|\) 重新排序, 在上述收敛条件下相邻子空间的渐近收缩因子变为
\[b_j(\sigma) \sim \left|\frac{\lambda_{j+1}-\sigma}{\lambda_j-\sigma}\right|.\]若要从右下角隔离目标本征值, 取位移接近该目标, 使它对应较小的移后模; 因而缩小的是比值的分子. 逐步更新位移时不能直接把固定比值当作统一的全局收敛速率. 对实对称三对角矩阵, 常用 Wilkinson 位移: 选取当前矩阵 \(\mathbf{A}^{(k)}\) 右下角的 \(2\times2\) 子矩阵:
\[\mathbf{M} = \begin{pmatrix} a_{n-1,n-1}^{(k)} & a_{n-1,n}^{(k)}\\ a_{n,n-1}^{(k)} & a_{nn}^{(k)} \end{pmatrix}\]计算该子矩阵的两个特征值 \(\mu_{1}, \mu_{2}\), 选择更靠近 \(a_{nn}^{(k)}\) 的特征值作为位移参数 \(\sigma_{k}\), 即
\[\sigma_k = \begin{cases} \mu_1, & |\mu_1-a_{nn}^{(k)}|\lt |\mu_2-a_{nn}^{(k)}|,\\ \mu_2, & \text{otherwise}. \end{cases}\]对于一般实非对称上 Hessenberg 矩阵, 该子矩阵可能有复共轭本征值; 若要保持实运算, 通常采用包含两个共轭位移的 Francis 双位移 QR, 并以实 Schur 形式为目标.
7.5 Generalized Eigenvalue Problems *
对于两个矩阵 \(\mathbf{A}\) 和 \(\mathbf{B}\), 广义特征值问题可以写作
\[\mathbf{A}\mathbf{x} = \lambda\mathbf{B}\mathbf{x}\]如果 \(\mathbf{B}\) 是可逆的, 可以通过变换将其转化为标准特征值问题:
\[\mathbf{B}^{-1}\mathbf{A}\mathbf{x} = \lambda\mathbf{x}\]但是 \(\mathbf{B}^{-1}\mathbf{A}\) 不一定是对称矩阵, 不能直接套用对称矩阵本征算法. 数值实现通常通过求解线性方程组而避免显式形成逆矩阵. 当 \(\mathbf{A}, \mathbf{B}\) 对称且 \(\mathbf{B}\) 正定时, 可以利用 Cholesky 分解:
\[\mathbf{B} = \mathbf{L}\mathbf{L}^{\mathsf{T}}\]将原问题转化为
\[\mathbf{L}^{-1}\mathbf{A}\mathbf{L}^{-\mathsf{T}}\mathbf{y} = \lambda\mathbf{y}\]其中
\[\mathbf{y} = \mathbf{L}^{\mathsf{T}}\mathbf{x}\]7.6 SVD Decomposition *
本节取 \(\mathbf{A}\in\mathbb{R}^{m\times n}\); 非方阵没有通常意义的本征值问题, 但任意实矩阵都可以作 SVD 分解:
\[\mathbf{A} = \mathbf{U}\mathbf{D}\mathbf{V}^{\mathsf{T}}\]其中 \(\mathbf{U}\) 是一个 \(m \times m\) 的正交矩阵, \(\mathbf{V}\) 是一个 \(n \times n\) 的正交矩阵, \(\mathbf{D}\) 是一个 \(m \times n\) 的对角矩阵, 对角线上的元素为 \(\mathbf{A}\) 的奇异值.
如果 \(\mathbf{A}\) 是对称正定矩阵, 那么 \(\mathbf{U}=\mathbf{V}\), SVD 分解就退化为特征值分解, 此时 \(\mathbf{D}\) 的对角线元素即为 \(\mathbf{A}\) 的本征值.
SVD 分解可以按以下步骤构造:
构造 \(n \times n\) 对称半正定矩阵 \(\mathbf{A}^{\mathsf{T}}\mathbf{A}\):
\[\begin{aligned} \mathbf{A}^{\mathsf{T}} &= \mathbf{V}\mathbf{D}^{\mathsf{T}}\mathbf{U}^{\mathsf{T}},\\ \mathbf{A}^{\mathsf{T}}\mathbf{A} &= \mathbf{V}\mathbf{D}^{\mathsf{T}}\mathbf{D}\mathbf{V}^{\mathsf{T}}. \end{aligned}\]对 \(\mathbf{A}^{\mathsf{T}}\mathbf{A}\) 对角化. 其特征向量就是 SVD 中的右奇异向量 \(\mathbf{V}\), 特征值满足
\[\mathbf{D}^{\mathsf{T}}\mathbf{D} = \operatorname{diag}(\lambda_1,\lambda_2,\cdots,\lambda_n).\]取奇异值
\[\omega_i=\sqrt{\lambda_i}.\]设 \(r=\min(m,n)\), \(k=\operatorname{rank}(\mathbf{A})\), 则前 \(k\) 个奇异值为正, 后面的奇异值为零.
对每个非零奇异值, 构造左奇异向量
\[\mathbf{u}_i = \frac{1}{\omega_i} \mathbf{A}\mathbf{v}_i, \qquad i=1,2,\cdots,k.\]这些列向量正交归一:
\[\mathbf{u}_i^{\mathsf{T}}\mathbf{u}_j = \frac{1}{\omega_i\omega_j} \mathbf{v}_i^{\mathsf{T}}\mathbf{A}^{\mathsf{T}}\mathbf{A}\mathbf{v}_j = \delta_{ij}.\]补全 \(\mathbf{U}\) 为正交矩阵. 选取 \(m-k\) 个向量, 使它们与已有 \(k\) 列共同组成线性无关组, 再作 Gram-Schmidt 正交化.
构造 \(m\times n\) 对角矩阵 \(\mathbf{D}\):
\[D_{ij} = \begin{cases} \omega_i, & i=j\leq r,\\ 0, & \text{otherwise}. \end{cases}\]
Remark 上述 \(\mathbf{A}^{\mathsf{T}}\mathbf{A}\) 构造用于理解 SVD; 对满列秩矩阵有 \(\kappa_2(\mathbf{A}^{\mathsf{T}}\mathbf{A})=\kappa_2(\mathbf{A})^2\), 会放大小奇异值的数值误差. 实际算法通常直接双对角化 \(\mathbf{A}\), 避免显式形成 Gram 矩阵.
Example 对矩阵作 SVD 分解
\[\mathbf{A} = \begin{pmatrix} 1 & 0 & 1\\ 0 & 1 & 0\\ 0 & 1 & 1\\ 0 & 1 & 0\\ 1 & 1 & 0 \end{pmatrix}.\]Solution 首先计算 \(\mathbf{A}^{\mathsf{T}}\mathbf{A}\):
\[\mathbf{A}^{\mathsf{T}}\mathbf{A} = \begin{pmatrix} 2 & 1 & 1\\ 1 & 4 & 1\\ 1 & 1 & 2 \end{pmatrix}.\]求出 \(\mathbf{A}^{\mathsf{T}} \mathbf{A}\) 的特征值和特征向量, 得到
\[\begin{aligned} \lambda_1&=5, \qquad \lambda_2=2, \qquad \lambda_3=1,\\ \mathbf{V} &= \begin{pmatrix} \frac{\sqrt{6}}{6} & \frac{\sqrt{3}}{3} & -\frac{\sqrt{2}}{2}\\ \frac{\sqrt{6}}{3} & -\frac{\sqrt{3}}{3} & 0\\ \frac{\sqrt{6}}{6} & \frac{\sqrt{3}}{3} & \frac{\sqrt{2}}{2} \end{pmatrix}. \end{aligned}\]于是得到奇异值:
\[\omega_1=\sqrt{5}, \qquad \omega_2=\sqrt{2}, \qquad \omega_3=1.\]计算前三个左奇异向量:
\[\begin{aligned} \mathbf{u}_1 &= \frac{1}{\sqrt{5}}\mathbf{A}\mathbf{v}_1 = \left(\frac{\sqrt{30}}{15},\frac{\sqrt{30}}{15},\frac{\sqrt{30}}{10},\frac{\sqrt{30}}{15},\frac{\sqrt{30}}{10}\right)^{\mathsf{T}},\\ \mathbf{u}_2 &= \frac{1}{\sqrt{2}}\mathbf{A}\mathbf{v}_2 = \left(\frac{\sqrt{6}}{3},-\frac{\sqrt{6}}{6},0,-\frac{\sqrt{6}}{6},0\right)^{\mathsf{T}},\\ \mathbf{u}_3 &= \mathbf{A}\mathbf{v}_3 = \left(0,0,\frac{\sqrt{2}}{2},0,-\frac{\sqrt{2}}{2}\right)^{\mathsf{T}}. \end{aligned}\]取两个补全向量
\[\mathbf u_4=\frac1{\sqrt2}(0,1,0,-1,0)^{\mathsf T},\qquad \mathbf u_5=\frac1{\sqrt5}(1,1,-1,1,-1)^{\mathsf T}.\]它们属于 \(\ker\mathbf A^{\mathsf T}\), 彼此及与前三列正交归一. 因而完整分解为
\[\mathbf U=(\mathbf u_1,\mathbf u_2,\mathbf u_3,\mathbf u_4,\mathbf u_5),\quad \mathbf D=\begin{pmatrix}\sqrt5&0&0\\0&\sqrt2&0\\0&0&1\\0&0&0\\0&0&0\end{pmatrix},\quad \mathbf A=\mathbf U\mathbf D\mathbf V^{\mathsf T}.\]也可以保留前三列得到约化 SVD \(\mathbf A=\mathbf U_r\operatorname{diag}(\sqrt5,\sqrt2,1)\mathbf V^{\mathsf T}\).
SVD 分解可以用于图像压缩:
- 一张 \(N \times N\) 的灰度图像可以看作矩阵 \(\mathbf{A}\), 矩阵元对应像素亮度.
- 只保留前 \(k\) 个奇异值及其奇异向量, 其余奇异值置零, 得到秩为 \(k\) 的近似矩阵 \(\mathbf{A}_k\).
- 调整 \(k\) 可以在图像质量和存储空间之间权衡.
7.7 Power Method
幂法是一种简单而有效的迭代方法, 用于求解矩阵的主特征值(即绝对值最大的特征值)及其对应的特征向量. 假设一个 \(n \times n\) 矩阵 \(\mathbf{A}\) 有 \(n\) 个线性无关的特征向量 \(\mathbf{v}_1, \mathbf{v}_2, \cdots, \mathbf{v}_n\), 对应的特征值为 \(\lambda_1, \lambda_2, \cdots, \lambda_n\), 其中 \(|\lambda_1| > |\lambda_2| \geq \cdots \geq |\lambda_n|\).
取初始向量 \(\mathbf{x}\), 要求其在本征向量基中的系数 \(\beta_1\neq0\). 对一般非对称矩阵, 这不等价于 \(\mathbf{x}\) 不与右本征向量 \(\mathbf{v}_1\) 正交; 只有本征基正交时才可这样判断. 可以将初始向量表示为
\[\mathbf{x} = \beta_1\mathbf{v}_1 + \beta_2\mathbf{v}_2 + \cdots + \beta_n\mathbf{v}_n = \sum_{i=1}^{n} \beta_i\mathbf{v}_i.\]左乘 \(\mathbf{A}\):
\[\begin{aligned} \mathbf{A}\mathbf{x} &= \sum_{i=1}^{n} \beta_i\lambda_i\mathbf{v}_i,\\ \mathbf{A}^{2}\mathbf{x} &= \sum_{i=1}^{n} \beta_i\lambda_i^{2}\mathbf{v}_i,\\ &\cdots\\ \mathbf{A}^{k}\mathbf{x} &= \sum_{i=1}^{n} \beta_i\lambda_i^{k}\mathbf{v}_i. \end{aligned}\]写作
\[\mathbf{A}^{k}\mathbf{x} = \lambda_1^{k} \sum_{i=1}^{n} \beta_i \left( \frac{\lambda_i}{\lambda_1} \right)^{k} \mathbf{v}_i.\]由于 \(|\lambda_1|>|\lambda_2|\geq\cdots\geq|\lambda_n|\), 当 \(k\) 足够大时, \(\left(\frac{\lambda_i}{\lambda_1}\right)^k\to0\) (\(i=2,3,\cdots,n\)), 因此求和只有第一项有贡献:
\[\mathbf{A}^{k}\mathbf{x} \sim \lambda_1^{k} \beta_1\mathbf{v}_1, \qquad k\to\infty.\]幂法通常采用无穷范数归一化条件
\[\left\| \mathbf{x}^{(k)} \right\|_{\infty} = 1\]即每个迭代向量的最大分量绝对值为 1, 以避免数值溢出. 算法步骤如下:
任取一个初始向量 \(\mathbf{x}^{(0)}\), 满足 \(\|\mathbf{x}^{(0)}\|_{\infty}=1\).
重复计算并归一化:
\[\begin{aligned} \mathbf{y}^{(k)} = \mathbf{A}\mathbf{x}^{(k)}, \qquad \mathbf{x}^{(k+1)} &= \frac{\mathbf{y}^{(k)}}{\|\mathbf{y}^{(k)}\|_{\infty}}. \end{aligned}\]选取 \(\mathbf{x}^{(k)}\) 最大分量对应的指标 \(m_k\), 估计本征值:
\[\mu^{(k)} = \frac{(\mathbf{A}\mathbf{x}^{(k)})_{m_k}}{x_{m_k}^{(k)}}.\]
如果 \(\mathbf{x}^{(0)}\) 恰好是特征向量, 则 \(\mathbf{A}\mathbf{x}^{(0)}=\lambda\mathbf{x}^{(0)}\), 任意非零分量都满足 \((\mathbf{A}\mathbf{x}^{(0)})_m/x_m^{(0)}=\lambda\).
由本节前面的本征向量展开, 可以进一步写出分量比估计. 在第 \(k\) 步选取 \(\mathbf{x}^{(k)}\) 最大分量对应的指标 \(m_k\), 有
\[\mu^{(k)} = \lambda_1 \frac{ \beta_1v_{1,m_k} + \sum_{i=2}^{n} \beta_i(\lambda_i/\lambda_1)^{k+1} v_{i,m_k} }{ \beta_1v_{1,m_k} + \sum_{i=2}^{n} \beta_i(\lambda_i/\lambda_1)^k v_{i,m_k} }.\]可以看到, 当 \(k\to\infty\) 时, \(\mu^{(k)}\to\lambda_1\), \(\mathbf{x}^{(k)}\) 的方向趋于 \(\mathbf{v}_1\), 最终迭代得到最大特征值.
Example 求矩阵的最大本征值
\[\mathbf{A} = \begin{pmatrix} -2 & -3\\ 6 & 7 \end{pmatrix}.\]规定初始向量 \(\mathbf{x}_0=(1,1)^{\mathsf{T}}\). 连续迭代得到
\[\begin{aligned} \mathbf{x}_1 &= \begin{pmatrix}-5\\13\end{pmatrix}, \qquad \mathbf{x}_2 &= \begin{pmatrix}-29\\61\end{pmatrix}, \qquad \mathbf{x}_3 &= \begin{pmatrix}-125\\253\end{pmatrix},\\ \mathbf{x}_4 &= \begin{pmatrix}-509\\1021\end{pmatrix}, \qquad \mathbf{x}_5 &= \begin{pmatrix}-2045\\4093\end{pmatrix}, \qquad \mathbf{x}_6 &= \begin{pmatrix}-8189\\16381\end{pmatrix}. \end{aligned}\]最大本征值:
\[\lambda_1^{(1)}=\frac{61}{13}=4.6923,\quad \lambda_1^{(2)}=\frac{253}{61}=4.1475,\quad \lambda_1^{(3)}=\frac{1021}{253}=4.0356\]\[\lambda_1^{(4)}=\frac{4093}{1021}=4.0088,\qquad \lambda_1^{(5)}=\frac{16381}{4093}=4.0022.\]本例的精确特征多项式为 \((\lambda-4)(\lambda-1)\), 故主本征值为 \(4\), 对应方向可取 \((-1,2)^{\mathsf T}\). 上述比值趋于 \(4\), 并非第五个比值已经等于精确值.
对于对称矩阵, 可以直接用 Rayleigh quotient 来估计特征值:
\[\mu^{(k)} = \frac{ (\mathbf{x}^{(k)})^{\mathsf{T}} \mathbf{A} \mathbf{x}^{(k)} }{ (\mathbf{x}^{(k)})^{\mathsf{T}} \mathbf{x}^{(k)} }.\]如果用 2-范数归一化条件, 即 \(\|\mathbf{x}^{(k)}\|_2 = 1\), 则可以写作
\[\mu^{(k)} = (\mathbf{x}^{(k)})^{\mathsf{T}} \mathbf{A} \mathbf{x}^{(k)} = (\mathbf{x}^{(k)})^{\mathsf{T}} \mathbf{y}^{(k)}.\]在对称矩阵中, Rayleigh 商的本征值误差对邻近本征向量的方向误差是二阶的; 但幂法的方向收敛仍受 \(|\lambda_2/\lambda_1|\) 控制, 谱间隔小时可能很慢. 负主本征值或复相位可使归一化向量逐步变号或变相位, 收敛应理解为本征方向的收敛.
7.8 Inverse Power Method
反幂法是幂法的一种变体, 用于计算离某个给定位移 \(q\) 最近的特征值及其特征向量. 反幂法不是直接对 \(\mathbf{A}\) 做幂法, 而是对 \((\mathbf{A}-q\mathbf{I})^{-1}\) 做幂法. 这里要求 \(q\) 不等于任何本征值.
若 \(\mathbf{A}\) 的特征值为 \(\lambda_1, \lambda_2, \cdots, \lambda_n\), 则 \((\mathbf{A}-q\mathbf{I})^{-1}\) 的特征值为
\[\frac{1}{\lambda_1-q}, \frac{1}{\lambda_2-q}, \cdots, \frac{1}{\lambda_n-q}\]且特征向量保持不变. 对可对角化矩阵, 若离 \(q\) 最近的本征值唯一, 且初始向量在其本征向量基中的系数非零, 才有对应的主方向收敛保证; 等距的多个本征值可能阻止单方向收敛.
对 \((\mathbf{A}-q\mathbf{I})^{-1}\) 做幂法, 会找到模最大的特征值, 这等价于找到离 \(q\) 最近的 \(\lambda_i\). 过程和幂法完全一样, 只不过每次迭代都要解线性方程组:
\[(\mathbf{A}-q\mathbf{I})\mathbf{y}^{(k)} = \mathbf{x}^{(k)}\]以避免显式求解逆矩阵.
本征值:
\[\lambda = q + \frac{1}{\mu}\]7.9 Wielandt Deflation
Remark 已经用幂法求出矩阵 \(\mathbf{A}\) 的最大特征值 \(\lambda_1\) 和对应特征向量 \(\mathbf{v}_1\) 后, 若继续直接用幂法, 仍会收敛到 \(\lambda_1\). Wielandt deflation 的目标是构造新矩阵, 消除 \(\lambda_1\), 让 \(\lambda_2\) 成为新矩阵中的主特征值.
Definition 取向量 \(\mathbf{x}\) 满足
\[\mathbf{x}^{\mathsf{T}}\mathbf{v}_1=1\]并构造
\[\mathbf{B} = \mathbf{A} - \lambda_1\mathbf{v}_1\mathbf{x}^{\mathsf{T}}\]Proof 消去主本征值. 由 \(\mathbf{x}^{\mathsf{T}}\mathbf{v}_1=1\) 可得
\[\mathbf{B}\mathbf{v}_1 = \mathbf{A}\mathbf{v}_1 - \lambda_1\mathbf{v}_1(\mathbf{x}^{\mathsf{T}}\mathbf{v}_1) = \lambda_1\mathbf{v}_1-\lambda_1\mathbf{v}_1 = \mathbf{0}\]\(\mathbf{v}_1\) 是 \(\mathbf{B}\) 属于本征值 \(0\) 的本征向量.
Proof 保留其他本征值. 对于 \(\lambda_i\neq0\), 构造向量
\[\mathbf{w}_i = \mathbf{v}_i - \frac{\lambda_1\mathbf{x}^{\mathsf{T}}\mathbf{v}_i}{\lambda_i} \mathbf{v}_1\]其中 \(\mathbf{v}_i\) 是 \(\mathbf{A}\) 的第 \(i\) 个特征值 \(\lambda_i\) 对应的特征向量. 记
\[\mathbf{x}^{\mathsf{T}}\mathbf{w}_i = \mathbf{x}^{\mathsf{T}}\mathbf{v}_i \left(1-\frac{\lambda_1}{\lambda_i}\right).\]代入 \(\mathbf{B}\mathbf{w}_i\) 可得
\[\begin{aligned} \mathbf{B}\mathbf{w}_i &= \mathbf{A}\mathbf{w}_i - \lambda_1\mathbf{v}_1\mathbf{x}^{\mathsf{T}}\mathbf{w}_i\\ &= \lambda_i\mathbf{v}_i - \frac{\lambda_1^2\mathbf{x}^{\mathsf{T}}\mathbf{v}_i}{\lambda_i}\mathbf{v}_1 - \lambda_1\mathbf{x}^{\mathsf{T}}\mathbf{v}_i \left(1-\frac{\lambda_1}{\lambda_i}\right)\mathbf{v}_1\\ &= \lambda_i\mathbf{v}_i - \lambda_1\mathbf{x}^{\mathsf{T}}\mathbf{v}_i\mathbf{v}_1 = \lambda_i\mathbf{w}_i. \end{aligned}\]所以 \(\lambda_{i}\) 也是 \(\mathbf{B}\) 的本征值, 对应的本征向量为 \(\mathbf{w}_{i}\).
Remark 降阶问题. 一种构造 \(\mathbf{x}\) 的方法是选取 \(v_{1i}\neq0\) 的分量, 令
\[\mathbf{x} = \frac{1}{\lambda_1 v_{1i}} \begin{pmatrix} a_{i1}\\ a_{i2}\\ \vdots\\ a_{in} \end{pmatrix}\]其中 \(a_{ij}\) 是矩阵 \(\mathbf{A}\) 的元素. 此时
\[\mathbf{x}^{\mathsf{T}}\mathbf{v}_1 = \frac{1}{\lambda_1 v_{1i}} \sum_{j=1}^{n}a_{ij}v_{1j} = \frac{1}{\lambda_1 v_{1i}}(\mathbf{A}\mathbf{v}_1)_i = \frac{1}{\lambda_1 v_{1i}}\lambda_1 v_{1i} = 1\]作用后 \(\mathbf{B}\) 的第 \(i\) 行元素全为 \(0\). 删除第 \(i\) 行和第 \(i\) 列, 对降阶矩阵继续用幂法, 就可以求出 \(\lambda_2\).
Example
\[\mathbf{A} = \begin{pmatrix} 4 & -1 & 1\\ -1 & 3 & -2\\ 1 & -2 & 3 \end{pmatrix}\]Solution 幂法求出 \(\lambda_1=6\), 对应的特征向量为 \(\mathbf{v}_1=(1,-1,1)^{\mathsf{T}}\). 构造向量 \(\mathbf{x}\):
\[\begin{aligned} \mathbf{x} &= \frac{1}{6} \begin{pmatrix} 4\\ -1\\ 1 \end{pmatrix},\\ \mathbf{v}_1\mathbf{x}^{\mathsf{T}} &= \begin{pmatrix} \frac{2}{3} & -\frac{1}{6} & \frac{1}{6}\\ -\frac{2}{3} & \frac{1}{6} & -\frac{1}{6}\\ \frac{2}{3} & -\frac{1}{6} & \frac{1}{6} \end{pmatrix},\\ \mathbf{B} &= \mathbf{A} - \lambda_1\mathbf{v}_1\mathbf{x}^{\mathsf{T}} = \begin{pmatrix} 0 & 0 & 0\\ 3 & 2 & -1\\ -3 & -1 & 2 \end{pmatrix}. \end{aligned}\]删除第一行和第一列:
\[\mathbf{B}' = \begin{pmatrix} 2 & -1\\ -1 & 2 \end{pmatrix}\]再次用幂法求出 \(\lambda_2=3\), 降阶矩阵的特征向量为 \(\mathbf v'_2=(1,-1)^{\mathsf T}\). 插回被删除的零分量, 得 \(\mathbf w=(0,1,-1)^{\mathsf T}\), 它是 \(\mathbf B\) 的特征向量. 原矩阵的向量须再恢复:
\[\mathbf v_2=\mathbf w+\frac{\lambda_1}{\lambda_2-\lambda_1}(\mathbf x^{\mathsf T}\mathbf w)\mathbf v_1 =\frac13(2,1,-1)^{\mathsf T}.\]因此可取 \(\mathbf A\) 的本征向量为 \((2,1,-1)^{\mathsf T}\), 直接检验 \(\mathbf A\mathbf v_2=3\mathbf v_2\). 降阶向量不能直接当作原矩阵的本征向量.
7.10 Krylov Subspace Methods
Krylov 子空间方法用于高效求解大型稀疏矩阵的特征值或线性方程组, 而不需要直接处理 \(n \times n\) 的完整矩阵.
Definition Krylov 矩阵. 设 \(\mathbf{A}\) 是 \(n \times n\) 大规模系数矩阵, \(\mathbf{b}\) 是 \(n\) 维列向量, 定义 \(n\) 阶 Krylov 矩阵 \(\mathbf{K}\):
\[\mathbf{K} = \left( \mathbf{b}\quad \mathbf{A}\mathbf{b}\quad \mathbf{A}^2\mathbf{b}\quad \cdots\quad \mathbf{A}^{n-1}\mathbf{b} \right)\]这些列张成 Krylov 子空间, 不要求它们全部线性无关:
\[\mathcal{K}_n(\mathbf{A}, \mathbf{b}) = \operatorname{span}\{\mathbf{b}, \mathbf{A}\mathbf{b}, \mathbf{A}^{2}\mathbf{b}, \cdots, \mathbf{A}^{n-1}\mathbf{b}\}.\]这个子空间是 \(\mathbf{A}\)-不变的:
\[\mathbf{A}\mathcal{K}_n(\mathbf{A}, \mathbf{b}) \subseteq \mathcal{K}_n(\mathbf{A}, \mathbf{b})\]左乘 \(\mathbf{A}\) 得到
\[\mathbf{A}\mathbf{K} = \left( \mathbf{A}\mathbf{b}\quad \mathbf{A}^2\mathbf{b}\quad \mathbf{A}^3\mathbf{b}\quad \cdots\quad \mathbf{A}^n\mathbf{b} \right)\]Proposition Hessenberg 约化. 以下假设 \(\mathbf{K}\) 的 \(n\) 列线性无关, 从而 \(\mathbf{K}\) 可逆. \(\mathbf{A}\mathbf{K}\) 的前 \(n-1\) 列正好是 \(\mathbf{K}\) 的第 2 列到第 \(n\) 列. 最后一列 \(\mathbf{A}^{n}\mathbf{b}\) 可写成 \(\mathbf{K}\) 各列的线性组合:
\[\mathbf{A}^n\mathbf{b} = c_1\mathbf{b} + c_2\mathbf{A}\mathbf{b} + c_3\mathbf{A}^2\mathbf{b} + \cdots + c_n\mathbf{A}^{n-1}\mathbf{b} = \mathbf{K}\mathbf{c}\]其中
\[\mathbf{c}=(c_1,c_2,\cdots,c_n)^{\mathsf{T}}\]因此
\[\mathbf{A}\mathbf{K}=\mathbf{K}\mathbf{G}\]其中
\[\mathbf{G} = \begin{pmatrix} 0 & 0 & \cdots & 0 & c_1\\ 1 & 0 & \cdots & 0 & c_2\\ 0 & 1 & \cdots & 0 & c_3\\ \vdots & \vdots & \ddots & \vdots & \vdots\\ 0 & 0 & \cdots & 1 & c_n \end{pmatrix}\]\(\mathbf{G}\) 是一个上 Hessenberg 矩阵. 于是
\[\mathbf{A}=\mathbf{K}\mathbf{G}\mathbf{K}^{-1}\]因此 \(\mathbf{A}\) 与 \(\mathbf{G}\) 相似, 具有相同的特征值. \(\mathbf{G}\) 是稀疏矩阵, 求解其特征值比直接求解 \(\mathbf{A}\) 更容易.
Remark 数值构造. 直接形成幂向量矩阵 \(\mathbf{K}\) 并求 \(\mathbf{G}\) 往往病态. 下面的 QR 分解说明正交基下的等价关系; 浮点实现应在每步生成新方向时立即正交化, 而不是先形成完整的 \(\mathbf{K}\) 再分解. 这种逐步构造将在 Lanczos 与 Arnoldi 迭代中实现. 理论上写作
\[\mathbf{K}=\mathbf{Q}\mathbf{R}\]\(\mathbf{Q}\) 为正交矩阵, \(\mathbf{R}\) 为上三角矩阵.
\[(\mathbf{Q}\mathbf{R})^{-1}\mathbf{A}(\mathbf{Q}\mathbf{R}) = \mathbf{G}\]两边左乘 \(\mathbf{R}\), 再右乘 \(\mathbf{R}^{-1}\), 得
\[\mathbf{Q}^{\mathsf{T}}\mathbf{A}\mathbf{Q} = \mathbf{R}\mathbf{G}\mathbf{R}^{-1}\]记作 \(\mathbf{T}\):
\[\mathbf{Q}^{\mathsf{T}}\mathbf{A}\mathbf{Q} = \mathbf{R}\mathbf{G}\mathbf{R}^{-1} = \mathbf{T}\]\(\mathbf{T}\) 是一个上 Hessenberg 矩阵, 且与 \(\mathbf{A}\) 相似, 具有相同的特征值. 对 \(\mathbf{T}\) 进行 QR 迭代, 就可以求出 \(\mathbf{A}\) 的特征值.
7.11 Lanczos Iteration
Proposition 如果 \(\mathbf{A}\) 为对称矩阵, Lanczos 迭代会把 Krylov 子空间中的投影压缩成一个三对角矩阵:
\[\mathbf{T} = \mathbf{Q}^{\mathsf{T}}\mathbf{A}\mathbf{Q} = \begin{pmatrix} \alpha_1 & \beta_1 & 0 & \cdots & 0\\ \beta_1 & \alpha_2 & \beta_2 & \cdots & 0\\ 0 & \beta_2 & \alpha_3 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & \alpha_n \end{pmatrix}\]这个三对角矩阵 \(\mathbf{T}\) 可以通过 Lanczos 迭代来构造. 将 Lanczos 基写作:
\[\mathbf{Q} = \left( \mathbf{q}_1\quad \mathbf{q}_2\quad \cdots\quad \mathbf{q}_n \right)\]在完整正交基下, \(\mathbf{A}\mathbf{Q}=\mathbf{Q}\mathbf{T}\) 可以写作:
\[\mathbf{A}\mathbf{q}_i = \beta_{i-1}\mathbf{q}_{i-1} + \alpha_i\mathbf{q}_i + \beta_i\mathbf{q}_{i+1}\]其中 \(\beta_0=0\), \(\mathbf{q}_0=\mathbf{0}\).
Proof 三项递推及投影关系:
\(\mathbf{Q}\) 的列向量两两正交, 满足
\[\mathbf{q}_i^{\mathsf{T}}\mathbf{q}_j=\delta_{ij}.\]三项递推左乘 \(\mathbf{q}_i^{\mathsf{T}}\) 得到对角元; 减去已知的两项后, 以残量范数归一化得到下一基向量. 具体公式和零残量处理统一列在下方迭代步骤中.
若迭代步数 \(m=n\), 则得到精确分解:
\[\mathbf{T}=\mathbf{V}\mathbf{E}\mathbf{V}^{\mathsf{T}}, \qquad \mathbf{A}=\mathbf{Q}\mathbf{V}\mathbf{E}\mathbf{V}^{\mathsf{T}}\mathbf{Q}^{\mathsf{T}}.\]若只迭代 \(m\lt n\) 步, 令 \(\mathbf{Q}_m=(\mathbf{q}_1,\cdots,\mathbf{q}_m)\). 在精确算术和基向量正交的条件下, 有
\[\mathbf{A}\mathbf{Q}_m =\mathbf{Q}_m\mathbf{T}_m+\mathbf{r}_m\mathbf{e}_m^{\mathsf{T}}, \qquad \mathbf{T}_m=\mathbf{Q}_m^{\mathsf{T}}\mathbf{A}\mathbf{Q}_m.\]其中 \(\mathbf{e}_m\in\mathbb{R}^m\) 是第 \(m\) 个标准基向量, \(\mathbf{r}_m\) 是最后一步尚未归一化的残量, 满足 \(\mathbf{Q}_m^{\mathsf{T}}\mathbf{r}_m=\mathbf{0}\) 和 \(\|\mathbf{r}_m\|_2=\beta_m\). 若 \(\beta_m>0\), 则 \(\mathbf{r}_m=\beta_m\mathbf{q}_{m+1}\); 若子空间已经闭合, 则 \(\mathbf{r}_m=\mathbf{0}\), 无需构造下一基向量. 完整基下残量也为零.
\(\mathbf{T}_m\) 是 \(\mathbf{A}\) 在当前 Krylov 子空间上的投影矩阵, 投影关系本身是精确的. 用它的本征对近似原矩阵的本征对时, 取 \(\mathbf{T}_m\mathbf{y}=\theta\mathbf{y}\), \(\|\mathbf{y}\|_2=1\), 则 Ritz 值为 \(\theta\), 对应的 Ritz 向量为
\[\mathbf{x}=\mathbf{Q}_m\mathbf{y}.\]其本征方程残量为
\[\mathbf{A}\mathbf{x}-\theta\mathbf{x} =\mathbf{r}_m\mathbf{e}_m^{\mathsf{T}}\mathbf{y}, \qquad \|\mathbf{A}\mathbf{x}-\theta\mathbf{x}\|_2 =\beta_m\left|\mathbf{e}_m^{\mathsf{T}}\mathbf{y}\right|.\]可用该残量是否达到所需容差判断本征对的近似精度; 浮点计算中还应注意基向量的正交性损失.
Remark Lanczos 迭代步骤:
初始化. 取一个非零初始向量 \(\mathbf{q}_1\), 归一化到 \(\|\mathbf{q}_1\|_2=1\); 再令 \(\mathbf{q}_0=\mathbf{0}\), \(\beta_0=0\).
计算对角元. 在第 \(i\) 步, 先求
\[\alpha_i=\mathbf{q}_i^{\mathsf{T}}\mathbf{A}\mathbf{q}_i.\]形成残量. 将当前向量投影到已知基上并减去:
\[\mathbf{v} = \mathbf{A}\mathbf{q}_i - \alpha_i\mathbf{q}_i - \beta_{i-1}\mathbf{q}_{i-1}.\]先计算残量范数:
\[\beta_i=\|\mathbf{v}\|_2.\]若 \(\beta_i=0\), 说明当前 Krylov 子空间已经闭合, 令实际步数 \(m=i\) 并终止递推, 不再除以 \(\beta_i\). 否则, 仅在需要继续迭代时计算
\[\mathbf{q}_{i+1}=\frac{\mathbf{v}}{\beta_i}.\]浮点实现应根据矩阵尺度和精度设定近零容差, 并在归一化前判断. 按容差终止表示数值上近似闭合, 应保留最后的残量范数用于精度检查; 必要时进行重正交化.
组装结果. 迭代 \(m\) 步后得到三对角矩阵 \(\mathbf{T}_m\), 其对角元是 \(\alpha_1,\alpha_2,\cdots,\alpha_m\), 次对角元是 \(\beta_1,\beta_2,\cdots,\beta_{m-1}\).
提取结果. 解
\[\mathbf{T}_m\mathbf{y}=\theta\mathbf{y}\]得到 Ritz 值 \(\theta\) 和归一化特征向量 \(\mathbf{y}\); 对应的 \(\mathbf{A}\) 的 Ritz 向量, 即近似本征矢, 为
\[\mathbf{x}=\mathbf{Q}_m\mathbf{y}.\]判断结果. 在精确算术下, 完整基给出全部精确本征对; 若在 \(m\lt n\) 时子空间已经闭合, 则得到该不变子空间内的精确本征对, 不代表获得全部谱. 一般截断时按上述 Ritz 残量检查目标本征对的精度. 若 \(\mathbf{q}_1\) 在最大本征方向上有非零投影, 最大 Ritz 值会随子空间扩展收敛到 \(\lambda_{\max}(\mathbf{A})\).
Example
\[\mathbf{A} = \begin{pmatrix} 3 & 2 & 5\\ 2 & 3 & 5\\ 5 & 5 & 0 \end{pmatrix}\]Solution 作两步 Lanczos 迭代:
初始化:
\[\mathbf{q}_0=\mathbf{0}, \qquad \mathbf{q}_1=(1,0,0)^{\mathsf{T}}, \qquad \beta_0=0.\]第一步迭代:
\[\alpha_1=3, \qquad \mathbf{v}_1=(0,2,5)^{\mathsf{T}} \implies \beta_1=\sqrt{29}, \qquad \mathbf{q}_2=\frac{1}{\sqrt{29}}(0,2,5)^{\mathsf{T}}.\]第二步给出投影矩阵的第二个对角元:
\[\alpha_2=\mathbf{q}_2^{\mathsf{T}}\mathbf{A}\mathbf{q}_2=\frac{112}{29}.\]两步后的三对角矩阵为
\[\mathbf{T}_2 = \begin{pmatrix} 3 & \sqrt{29}\\ \sqrt{29} & \frac{112}{29} \end{pmatrix}.\]
得到本征值的近似值:
\[\lambda_1 \approx 8.83, \qquad \lambda_2 \approx -1.97\]7.12 Arnoldi Iteration *
Arnoldi 迭代将 Krylov 正交基的构造推广到实非对称矩阵, 在 \(m\) 维子空间内得到上 Hessenberg 投影矩阵 \(\mathbf{H}_m=\mathbf{Q}_m^{\mathsf{T}}\mathbf{A}\mathbf{Q}_m\). 只有构成完整 \(n\) 维正交基时, \(\mathbf{H}_n\) 才与 \(\mathbf{A}\) 相似; 一般截断投影的本征值只是 Ritz 值. 完整基下设矩阵:
\[\begin{aligned} \mathbf{H} &= \begin{pmatrix} h_{11} & h_{12} & h_{13} & \cdots & h_{1n}\\ h_{21} & h_{22} & h_{23} & \cdots & h_{2n}\\ 0 & h_{32} & h_{33} & \cdots & h_{3n}\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & h_{nn} \end{pmatrix},\\ \mathbf{H} &=\mathbf{Q}^{\mathsf{T}}\mathbf{A}\mathbf{Q},\\ \mathbf{A}\mathbf{q}_{j} &=\sum_{i=1}^{\min(j+1,n)}h_{ij}\mathbf{q}_{i},\qquad j=1,\cdots,n. \end{aligned}\]第一列:
\[\begin{aligned} \mathbf{A}\mathbf{q}_1 &= h_{11}\mathbf{q}_1+h_{21}\mathbf{q}_2,\\ h_{11} &= \mathbf{q}_1^{\mathsf{T}}\mathbf{A}\mathbf{q}_1,\\ \mathbf{v}_1 &= \mathbf{A}\mathbf{q}_1-h_{11}\mathbf{q}_1,\\ h_{21} &= \|\mathbf{v}_1\|_2,\\ \mathbf{q}_2 &= \frac{\mathbf{v}_1}{h_{21}}. \end{aligned}\]第二列:
\[\begin{aligned} \mathbf{A}\mathbf{q}_2 &= h_{12}\mathbf{q}_1+h_{22}\mathbf{q}_2+h_{32}\mathbf{q}_3,\\ h_{12} &= \mathbf{q}_1^{\mathsf{T}}\mathbf{A}\mathbf{q}_2,\\ h_{22} &= \mathbf{q}_2^{\mathsf{T}}\mathbf{A}\mathbf{q}_2,\\ \mathbf{v}_2 &= \mathbf{A}\mathbf{q}_2-h_{12}\mathbf{q}_1-h_{22}\mathbf{q}_2,\\ h_{32} &= \|\mathbf{v}_2\|_2,\\ \mathbf{q}_3 &= \frac{\mathbf{v}_2}{h_{32}}. \end{aligned}\]以上除法仅在对应残量范数非零时执行. 若 \(h_{j+1,j}=0\), 则当前子空间已经闭合, 停止递推; 浮点实现应在归一化前按尺度设置近零容差, 必要时重正交化.
迭代 \(m\lt n\) 步时, 保留末残量 \(\mathbf{r}_m\), 有
\[\mathbf{A}\mathbf{Q}_m=\mathbf{Q}_m\mathbf{H}_m+\mathbf{r}_m\mathbf{e}_m^{\mathsf{T}},\qquad \mathbf{Q}_m^{\mathsf{T}}\mathbf{r}_m=\mathbf{0},\qquad \|\mathbf{r}_m\|_2=h_{m+1,m}.\]取 \(\mathbf{H}_m\mathbf{y}=\theta\mathbf{y}\), \(\|\mathbf{y}\|_2=1\), 对应 Ritz 向量为 \(\mathbf{x}=\mathbf{Q}_m\mathbf{y}\), 其残量满足
\[\|\mathbf{A}\mathbf{x}-\theta\mathbf{x}\|_2=h_{m+1,m}|\mathbf{e}_m^{\mathsf{T}}\mathbf{y}|.\]这可检查本征方程残量; 对非正规矩阵, 小残量本身不保证本征值的前向误差同样小, 还取决于谱的条件性.
7.13 DMRG Algorithm
DMRG(density-matrix renormalization group) 在低纠缠的一维系统中, 通过保留最重要的子空间来求低能态. 对链的一个切分, 归一化态的 Schmidt 分解为
\[|\psi\rangle=\sum_{\alpha=1}^{r}s_\alpha|\alpha_L\rangle|\alpha_R\rangle,\qquad s_1\geq s_2\geq\cdots\geq0,\qquad\sum_\alpha s_\alpha^2=1.\]约化密度矩阵的本征值为 \(s_\alpha^2\). 保留最大的 \(D\) 项, 得给定态的最佳未归一化 Schmidt 秩 \(D\) 近似, 平方范数误差为丢弃权重 \(w_{\mathrm{disc}}=\sum_{\alpha>D}s_\alpha^2\). 归一化后按 \(F=|\langle\psi|\psi_D\rangle|^2\) 定义的保真度为 \(1-w_{\mathrm{disc}}\), 但这个单次截断指标不等于最终能量误差.
现代实现将波函数写为矩阵乘积态 MPS(matrix product state)
\[\psi_{s_1\cdots s_L}=A^{s_1}_1A^{s_2}_2\cdots A^{s_L}_L,\]开边界的首末虚指标维数为 1, 中间键维数限制为 \(D\). Hamiltonian 可表示为矩阵乘积算符, 避免构造整个 \(d^L\) 维矩阵.
- 初始化符合粒子数或自旋对称性的 MPS, 建立左右环境.
- 在其余张量固定时, 对一个或两个相邻格点求有效 Hamiltonian 的最低本征向量, 可调用 Lanczos 或 Davidson 方法.
- 双格点向量作奇异值分解, 根据最大键维数与丢弃权重阈值截断, 移动正交中心并更新环境.
- 左右往返扫描, 增加键维数, 直到能量、局域可观测量和截断指标稳定.
Remark 规范化基下的局部问题是普通本征问题; 非正交基需处理范数矩阵. 精确局部最小化降低当前子问题能量, 但双格点截断后能量不必逐步单调. 固定键维数的优化可能困于局部极小, 应改变初态并检查 \(\langle H^2\rangle-\langle H\rangle^2\), 与小系统精确对角化比较. 临界长链、二维映射和实时演化常需更大键维数; DMRG 并不是对任意多体态的无损压缩.1
8 Monte Carlo Methods
Monte Carlo 方法用随机抽样近似积分、期望值和随机过程. 其优势是误差主要随样本数缩放, 在高维问题中常比规则网格积分更可行.
8.1 Probability and Statistics Background
概率密度函数 \(p(x)\)
描述随机连续变量 \(X\) 在 \(x\) 附近的概率密度, 满足归一化条件
\[\int_{-\infty}^{\infty}p(x)\,\mathrm{d}x=1\]对于独立变量, 有
\[p(x,y)=p(x)p(y)\]累积分布函数 \(P(x)\)
给出随机变量取值不超过 \(x\) 的概率
\[P(x)=\int_{-\infty}^{x}p(t)\,\mathrm{d}t\]期望值 \(E[f(x)]\)
\[E[f(x)]=\int_{-\infty}^{\infty}f(x)p(x)\,\mathrm{d}x\]\(n\) 阶中心矩
\[\langle (x-\langle x\rangle)^n\rangle = \int_{-\infty}^{\infty}(x-\langle x\rangle)^n p(x)\,\mathrm{d}x\]\(n=2\) 时给出方差.
中心极限定理
设 \(x_{1}, x_{2}, \cdots, x_{n}\) 是独立同分布的随机变量, 具有有限期望值 \(\mu\) 和有限非零方差 \(0\lt\sigma^2\lt\infty\), 定义样本均值:
\[z=\frac{1}{n}\sum_{i=1}^{n}x_i\]中心极限定理是标准化变量的分布收敛:
\[\frac{\sqrt{n}(z-\mu)}{\sigma}\xrightarrow{\mathrm{d}}\mathcal{N}(0,1).\]因此大样本时可用 \(\mathcal{N}(\mu,\sigma^2/n)\) 近似样本均值分布; 均值本身在 \(n\to\infty\) 时集中于 \(\mu\). 若存在且适用局部密度近似, 可写
\[p(z)\approx \frac{1}{\sqrt{2\pi}\sigma/\sqrt{n}} \exp\left[-\frac{(z-\mu)^2}{2\sigma^2/n}\right].\]仅有中心极限定理并不保证任意离散分布拥有该概率密度, 也不保证尾部的相对误差小.
随机数生成器
一个良好的随机数生成器应该满足:
均匀性: 生成的数列在 [0,1] 上服从均匀分布;
独立性: 连续随机数之间的相关性可以忽略不计;
周期长: 数列重复的周期尽可能大, 避免短时间内循环;
速度快: 算法计算效率高.
计算机生成的随机数本质上是通过确定性的递推公式产生的, 因此是伪随机数. 只要初值 (种子) 相同, 序列就会重复, 这就引入了周期性.
下面给出四种常见的伪随机数生成算法:
Logistic 映射
\[x_{i+1}=r x_i(1-x_i)\]在一定的参数下可以产生混沌序列, 但是分布不均匀, 不常用作标准随机数生成器.
线性同余生成器 (LCG)
\[N_i=(aN_{i-1}+c)\bmod m\]这是一种经典且快速的方法, 但周期受限于 \(m\).
带记忆的线性同余
\[N_i=(aN_{i-1}+cN_{i-j})\bmod m\]使用了更早的状态, 可以延长周期.
减法的生成器
\[N_i=(N_{i-3}-N_{i-1})\bmod (2^{31}-1)\]
8.2 Hit-or-Miss Sampling
随机投点法是一种简单的 Monte Carlo 方法, 用于估计几何图形的面积或体积. 基本思想是, 在一个已知面积或体积的区域内随机投点, 统计落在目标图形内的点的比例, 从而估计目标图形的面积或体积.
这里假设 \(0\leq f(x)\leq1\), \(x\in[0,1]\), 从而曲线下方的目标区域完整包含在单位正方形内.
在矩形区域 \([0,1] \times [0,1]\) 内随机均匀投点 \(N\) 次, 每个点的坐标 \((x_i, y_i)\) 独立取值;
判断每个点是否落在曲线 \(y=f(x)\) 下方的区域 \(\Omega\) 内, 即条件 \(y_{i} \leq f(x_{i})\) 是否成立.
设 \(n\) 为满足条件的点数, 则曲线下面积的 Monte Carlo 估计值为
\[I=\frac{n}{N}\]
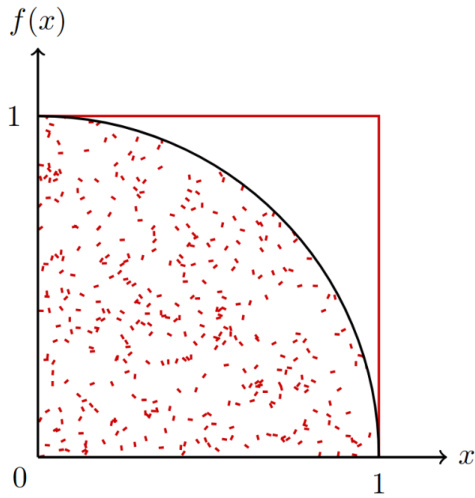
图中红点仅标出曲线下的命中点.
\(n\) 是命中数, \(N\) 是单位正方形内全部均匀投点数, 包括未在图中标出的未命中点; 不能把可见红点数同时当作分子和分母.
8.3 Expectation-Value Estimation
设 \(X_i\) 是从归一化分布 \(p\) 独立抽取的样本. 期望值与样本估计量应区分:
\[\mu_f=\mathbb{E}_p[f(X)]=\int f(x)p(x)\,\mathrm{d}x, \qquad \bar f_N=\frac{1}{N}\sum_{i=1}^N f(X_i).\]样本已经服从 \(p\), 因而均值中不能再乘一次 \(p(X_i)\). 若总体方差有限, 则
\[\sigma_f^2=\mathbb{E}_p[f^2]-\mu_f^2,\qquad \operatorname{Var}(\bar f_N)=\frac{\sigma_f^2}{N}.\]用样本估计方差与标准误差时, 可取
\[s_f^2=\frac{1}{N-1}\sum_{i=1}^N(f(X_i)-\bar f_N)^2, \qquad \widehat{\mathrm{SE}}(\bar f_N)=\frac{s_f}{\sqrt N}.\]这是独立样本的误差公式. 对平稳 MCMC 样本, 若自相关可求和且相应中心极限定理成立, 用 \(N_{\mathrm{eff}}\simeq N/[1+2\sum_{k\ge1}\rho_f(k)]\) 替代 \(N\), 其中 \(\rho_f(k)\) 是观测量 \(f\) 的滞后自相关. 尚未热化或未遍历不同模态造成的偏差不会被这个标准误差自动包含.
现在我们想计算积分:
\[I=\int_a^b f(x)\,\mathrm{d}x\]如果是均匀采样, 则
\[\begin{aligned} p(x) &= \frac{1}{b-a},\\ I &\approx \frac{b-a}{N}\sum_{i=1}^{N}f(x_i) \end{aligned}\]多维积分:
\[I\approx \frac{V}{N}\sum_{i=1}^{N}f(x_i)\]误差估计:
\[\widehat{\mathrm{SE}}(\hat I)=\frac{V s_f}{\sqrt{N}}\]这里 \(V\) 是积分区域体积, 一维时为 \(b-a\). 独立样本的 \(N^{-1/2}\) 速率不显含维度, 但方差、有效采样效率和计算成本都可能随维度恶化.
Importance Sampling 如果函数 \(f(x)\) 只在很小的区域内显著非零, 均匀采样的效率很低, 此时可以引入采样分布 \(p(x)\).
使用采样分布时须满足:
- 在被积函数非零的区域有 \(p(x)>0\);
- \(f(X)/p(X)\) 有有限方差才能使用上述标准误差.
- 从 \(p(x)\) 中抽取独立样本 \(x_1, x_2, \cdots, x_N\), 且 \(\int p(x)\,\mathrm{d}x = 1\).
可以用样本均值来估计期望值:
\[\begin{aligned} I &= \int_a^b f(x)\,\mathrm{d}x\\ &= \int_a^b \frac{f(x)}{p(x)}p(x)\,\mathrm{d}x\\ &\approx \frac{1}{N}\sum_{i=1}^{N}\frac{f(x_i)}{p(x_i)}. \end{aligned}\]Inverse Transform 直接生成服从 \(p(x)\) 的随机数有时候并不方便, 可以通过变量替换将积分变为均匀分布的形式. 定义累积分布函数:
\[\begin{aligned} y(x) &= \int_a^x p(t)\,\mathrm{d}t,\\ \mathrm{d}y &= p(x)\,\mathrm{d}x,\\ I &= \int_a^b p(x)\frac{f(x)}{p(x)}\,\mathrm{d}x\\ &= \int_0^1 \frac{f(x(y))}{p(x(y))}\,\mathrm{d}y\\ &\approx \frac{1}{N}\sum_{i=1}^{N} \frac{f(x(y_i))}{p(x(y_i))}. \end{aligned}\]当 \(x\) 从 \(a\) 到 \(b\) 时, \(y\) 从 0 到 1.
Example 如果取
\[\begin{aligned} p(x) &= \mathrm{e}^{-x},\\ \mathrm{d}y(x) &= p(x)\,\mathrm{d}x = \mathrm{e}^{-x}\,\mathrm{d}x,\\ y(x) &= \int_0^x \mathrm{e}^{-t}\,\mathrm{d}t = 1-\mathrm{e}^{-x},\\ x(y) &= -\ln(1-y). \end{aligned}\]求积分:
\[\begin{aligned} I &= \int_0^\infty \mathrm{e}^{-x}G(x)\,\mathrm{d}x\\ &= \int_0^1 G(-\ln(1-y))\,\mathrm{d}y\\ &\approx \frac{1}{N}\sum_{i=1}^{N}G(x(y_i)). \end{aligned}\]8.4 One-Dimensional Random Walk
建立一维随机行走模型: 在一维直线上, 质点每一步可以向左或向右移动, 步长为 \(l\). 向右的概率为 \(R\), 向左的概率为 \(L\), 满足 \(R + L = 1\). 假设各步独立, 每一步的位移 \(\Delta x_i=\pm l\), 如下图所示.

一维随机游走格点. 来源: 课程讲义.
原图 左侧第二个负坐标的标记省略了步长因子, 应读作 \(-2l\); 上方修正版已补上该因子.

首先考虑对称的情形, 即 \(R=L=\frac{1}{2}\).
经过 \(n\) 步之后的总位移:
\[\begin{aligned} x(n) &= \sum_{i=1}^{n}\Delta x_i,\\ \langle x(n)\rangle &= \sum_{i=1}^{n}\langle \Delta x_i\rangle\\ &= \sum_{i=1}^{n} \left(\frac{1}{2}l-\frac{1}{2}l\right) = 0,\\ \sigma_n^2 &= \langle x(n)^2\rangle\\ &= \left\langle \sum_{i=1}^{n}\Delta x_i \sum_{j=1}^{n}\Delta x_j \right\rangle\\ &= \sum_{i=1}^{n}\langle \Delta x_i^2\rangle + \sum_{i\neq j}\langle \Delta x_i\Delta x_j\rangle = nl^2. \end{aligned}\]如果是非对称情形:
\[\begin{aligned} \langle x(n)\rangle &= n(R-L)l,\\ \sigma_n^2 &= n[l^2-(R-L)^2l^2]\\ &= 4nRLl^2. \end{aligned}\]8.5 Markov Processes
Markov 过程是一种随机过程, 满足无记忆性, 即未来状态仅依赖于当前状态, 而与过去的状态无关.
Transition Matrix 定义转移概率矩阵 \(\mathbf{W}_{ij}(\varepsilon)\) 为在时间 \(\varepsilon\) 内从格点 \(j\) 转移到格点 \(i\) 的概率. 对于一维对称随机行走:
\[W_{ij}(\varepsilon) = \begin{cases} \frac{1}{2}, & |i-j|=1,\\ 0, & \text{otherwise}. \end{cases}\]8.5.1 Time Evolution
经过一个时间步长 \(\varepsilon\) 后, 粒子到达格点 \(i\) 的概率 \(w_i(t+\varepsilon)\) 等于: 从上一位置 \(j\) 转移到 \(i\) 的概率, 乘以粒子在 \(t\) 时刻位于 \(j\) 的概率, 再对所有 \(j\) 求和:
\[w_i(t+\varepsilon) = \sum_j W_{ij}(\varepsilon)w_j(t)\]多步演化:
\[\begin{aligned} w_i(2\varepsilon) &= \sum_j W_{ij}w_j(\varepsilon) = \sum_j W_{ij}\sum_k W_{jk}w_k(0)\\ &= \sum_k\sum_j W_{ij}W_{jk}w_k(0) = \sum_k (\mathbf{W}^2)_{ik}w_k(0). \end{aligned}\]以此类推:
\[w_i(n\varepsilon) = \sum_k(\mathbf{W}^n)_{ik}w_k(0)\]n-Step Transition 先考虑只保留格点 \(1,2,3,4\) 的有限系统. 下列矩阵把出界粒子从这四个格点中移除, 相当于吸收至未显式列出的边界外状态. 右移矩阵 \(\mathbf{R}\) 与左移矩阵 \(\mathbf{L}\) 分别为
\[\mathbf{R} = \begin{pmatrix} 0 & 0 & 0 & 0\\ 1 & 0 & 0 & 0\\ 0 & 1 & 0 & 0\\ 0 & 0 & 1 & 0 \end{pmatrix} \qquad \mathbf{L} = \begin{pmatrix} 0 & 1 & 0 & 0\\ 0 & 0 & 1 & 0\\ 0 & 0 & 0 & 1\\ 0 & 0 & 0 & 0 \end{pmatrix}\]转移矩阵为
\[\mathbf{W} = \frac{1}{2}(\mathbf{R}+\mathbf{L})\]2 步转移矩阵对应四种走法: 向左移 2 步, 向右移 2 步, 以及左右各一步的两种顺序.
\[\mathbf{W}^2 = \frac{1}{4} (\mathbf{R}^2+\mathbf{L}^2+\mathbf{R}\mathbf{L}+\mathbf{L}\mathbf{R}).\]在这个有限系统中,
\[\mathbf{R}\mathbf{L}=\operatorname{diag}(0,1,1,1),\qquad \mathbf{L}\mathbf{R}=\operatorname{diag}(1,1,1,0),\]因此两矩阵不交换, 不能合并交叉项或直接使用二项式展开; \(\mathbf{W}\) 的端点列和为 \(1/2\), 内部列和为 \(1\), 四个格点中的总概率会随出界而减少.
以下另取无限晶格 \(i,j\in\mathbb{Z}\), 左右移算符互逆且交换, 满足 \(\mathbf{R}\mathbf{L}=\mathbf{L}\mathbf{R}=\mathbf{I}\). 此时才可用二项式定理
\[(a+b)^n = \sum_{k=0}^{n}\binom{n}{k}a^{n-k}b^k\]可将 \(n\) 步转移矩阵写作
\[\mathbf{W}^n = \frac{1}{2^n} \sum_{k=0}^{n}\binom{n}{k}\mathbf{R}^{n-k}\mathbf{L}^k\]也可等价写为
\[\mathbf{W}^n = \frac{1}{2^n}\sum_{k=0}^{n}\binom{n}{k}\mathbf{L}^{n-2k} = \frac{1}{2^n}\sum_{k=0}^{n}C_n^k\mathbf{R}^{2k-n}\]由于
\[\begin{aligned} (\mathbf{R}^m)_{ij} &= \delta_{i,j+m},\\ (\mathbf{L}^m)_{ij} &= \delta_{i+m,j}. \end{aligned}\]从起点 \(j\) 出发, 经过 \(n\) 步后到达位置 \(i\) 的概率为
\[W_{ij}^{n} = \frac{1}{2^n} \binom{n}{\frac{n+i-j}{2}}\]其中 \(\frac{n+i-j}{2}\) 必须是整数, 且满足 \(0 \leq \frac{n+i-j}{2} \leq n\).
8.5.2 Diffusion Equation
假设粒子从 \(x=0\) 出发, 初始分布为
\[w_j(0)=\delta_{j0}\]经过 \(n\) 步, 到达格点 \(i\) 的概率为
\[w_i(n\varepsilon) = \frac{1}{2^n} \binom{n}{\frac{n+i}{2}}\]Continuum Limit 组合数递推给出
\[\begin{aligned} \binom{n+1}{k} &= \binom{n}{k}+\binom{n}{k-1},\\ \binom{n+1}{\frac{n+1+i}{2}} &= \binom{n}{\frac{n+i+1}{2}} + \binom{n}{\frac{n+i-1}{2}},\\ \frac{1}{2^{n+1}}\binom{n+1}{\frac{n+1+i}{2}} &= \frac{1}{2^{n+1}}\binom{n}{\frac{n+i+1}{2}} + \frac{1}{2^{n+1}}\binom{n}{\frac{n+i-1}{2}}. \end{aligned}\]注意到
\[\begin{aligned} \frac{1}{2^{n+1}}\binom{n+1}{\frac{n+1+i}{2}} &= w_i[(n+1)\varepsilon],\\ \frac{1}{2^{n+1}}\binom{n}{\frac{n+i+1}{2}} &= \frac{1}{2}w_{i+1}(n\varepsilon),\\ \frac{1}{2^{n+1}}\binom{n}{\frac{n+i-1}{2}} &= \frac{1}{2}w_{i-1}(n\varepsilon). \end{aligned}\]因此
\[w_i[(n+1)\varepsilon] = \frac{1}{2}w_{i+1}(n\varepsilon) + \frac{1}{2}w_{i-1}(n\varepsilon)\]令
\[\begin{aligned} x&=il,\qquad t=n\varepsilon,\\ p_l(x,t)&=\frac{w_i(n\varepsilon)}{l},\\ p_l(x,t+\varepsilon) &= \frac{1}{2}p_l(x+l,t)+\frac{1}{2}p_l(x-l,t). \end{aligned}\]这是无限晶格上的离散扩散关系. 若将 \(p_l\) 在各宽度为 \(l\) 的格点单元内作常值延拓, 则 \(\int p_l(x,t)\,\mathrm{d}x=\sum_iw_i(t)=1\). 移项得到
\[\frac{p_l(x,t+\varepsilon)-p_l(x,t)}{\varepsilon} = \frac{l^2}{2\varepsilon} \frac{p_l(x+l,t)-2p_l(x,t)+p_l(x-l,t)}{l^2}.\]每步必移动的晶格游走保留奇偶性, 因而这个离散密度不在所有格点上逐点趋于光滑函数. 连续极限应理解为概率分布的弱收敛, 或先在相邻格点上作粗粒化后得到光滑密度 \(w(x,t)\). 对光滑尺度的差分作 Taylor 展开, 再取扩散尺度极限
当
\[\varepsilon\to 0, \qquad l\to 0, \qquad \frac{l^2}{2\varepsilon}\to D\]可以写作:
\[\frac{\partial w}{\partial t} = D\frac{\partial^2 w}{\partial x^2}\]这就是一维扩散方程, 其中 \(D\) 为扩散系数.
方差:
\[\langle x^2\rangle-\langle x\rangle^2=2Dt\]在无限长线上, 初始密度为 \(w(x,0)=\delta(x)\), 对 \(t>0\) 有归一化的 Gaussian 解:
\[w(x,t) = \frac{1}{\sqrt{4\pi Dt}} \exp\left(-\frac{x^2}{4Dt}\right)\]8.5.3 Finite-State Equilibrium
Example 转移矩阵
\[\mathbf{W} = \begin{pmatrix} \frac{1}{4} & \frac{1}{8} & \frac{2}{3}\\ \frac{3}{4} & \frac{5}{8} & 0\\ 0 & \frac{1}{4} & \frac{1}{3} \end{pmatrix}\]\[\mathbf{w}(0)=(1,0,0)^{\mathsf{T}}\]Solution 时间演化:
\[\begin{aligned} \mathbf{w}(\varepsilon) &= \mathbf{W}\mathbf{w}(0) = \left(\frac{1}{4},\frac{3}{4},0\right)^{\mathsf{T}},\\ \mathbf{w}(2\varepsilon) &= \mathbf{W}\mathbf{w}(\varepsilon) = \left(\frac{5}{32},\frac{21}{32},\frac{3}{16}\right)^{\mathsf{T}}. \end{aligned}\]平衡态满足
\[\mathbf{w}(\infty)=\mathbf{W}\mathbf{w}(\infty)\]即
\[\begin{aligned} W_{11}w_1(\infty)+W_{12}w_2(\infty)+W_{13}w_3(\infty) &= w_1(\infty),\\ W_{21}w_1(\infty)+W_{22}w_2(\infty)+W_{23}w_3(\infty) &= w_2(\infty),\\ W_{31}w_1(\infty)+W_{32}w_2(\infty)+W_{33}w_3(\infty) &= w_3(\infty). \end{aligned}\]再加归一化条件
\[\sum_i w_i(\infty)=1\]解得
\[\mathbf{w}(\infty) = \left(\frac{4}{15},\frac{8}{15},\frac{1}{5}\right)^{\mathsf{T}}\]这个有限状态例子的转移矩阵不可约且有自环, 因而非周期, 从任意初态收敛到唯一平稳分布. 一般 Markov 链不能无条件断言收敛. 对本例可对角化的 \(\mathbf{W}\), 将初始分布按本征向量展开:
\[\mathbf{w}(0)=\sum_i \alpha_i\mathbf{v}_i\]经过 \(t\) 步后:
\[\mathbf{w}(t) = \mathbf{W}^t\mathbf{w}(0) = \sum_i\lambda_i^t\alpha_i\mathbf{v}_i\]有限状态随机矩阵总有本征值 \(1\), 且所有本征值满足 \(|\lambda_i|\leq1\). 若链不可约且非周期, 则 \(1\) 是单本征值, 其余本征值才满足 \(|\lambda_i|\lt1\). 可约链可能有多个平稳分布, 周期链可能有其他单位模本征值, 例如两状态交替链有 \(\lambda=-1\). 对本例, 当 \(t\to\infty\) 时, 只有 \(\lambda_i=1\) 的项保留:
\[\mathbf{w}(\infty) \propto \text{eigenvector corresponding to eigenvalue }1\]对于刚才的例子, 对角化得到特征值
\[\mathbf{D} = \begin{pmatrix} 1 & 0 & 0\\ 0 & \frac{1}{48}(5-\mathrm{i}\sqrt{311}) & 0\\ 0 & 0 & \frac{1}{48}(5+\mathrm{i}\sqrt{311}) \end{pmatrix}\]特征矢量为
\[\begin{aligned} \mathbf{v}_1 &= \begin{pmatrix} \frac{4}{3}\\ \frac{8}{3}\\ 1 \end{pmatrix},\\ \mathbf{v}_2 &= \begin{pmatrix} -\frac{1}{12}+\mathrm{i}\frac{\sqrt{311}}{12}\\ -\frac{11}{12}-\mathrm{i}\frac{\sqrt{311}}{12}\\ 1 \end{pmatrix},\\ \mathbf{v}_3 &= \begin{pmatrix} -\frac{1}{12}-\mathrm{i}\frac{\sqrt{311}}{12}\\ -\frac{11}{12}+\mathrm{i}\frac{\sqrt{311}}{12}\\ 1 \end{pmatrix}. \end{aligned}\]将第一个特征矢量归一化, 得到
\[\mathbf{w}(\infty) = \left(\frac{4}{15},\frac{8}{15},\frac{1}{5}\right)^{\mathsf{T}}\]8.5.4 Continuous-Time Rates
先区分连续时间转移速率与离散时间转移概率. 若 \(\Gamma(j\to i)\) 表示连续时间速率, 则主方程为
\[\frac{\mathrm{d}w_i}{\mathrm{d}t} = \sum_{j\neq i}\left[\Gamma(j\to i)w_j-\Gamma(i\to j)w_i\right].\]平稳条件只要求总流入与总流出相等:
\[\sum_{j\neq i}\Gamma(j\to i)w_j=\sum_{j\neq i}\Gamma(i\to j)w_i.\]若进一步要求 \(\Gamma(j\to i)w_j=\Gamma(i\to j)w_i\) 对每一对状态成立, 才得到细致平衡. 以下 Metropolis 更新使用离散时间提议和转移概率.
8.6 Metropolis Algorithm
逐对相等是细致平衡, 它是目标分布保持不变的充分而非必要条件. 从任意初态收敛还需要遍历性: 有限状态链通常要求不可约和非周期; 满足细致平衡却困在某个子集的链并不能正确采样整个目标分布.
当直接知道 \(W\) 很困难时(分布复杂、维度高、归一化常数未知等), Metropolis 算法通过对称提议分布与接受概率构造满足细致平衡条件的转移矩阵, 从而使采样分布收敛到目标分布.
将转移矩阵分解:
\[W(j\to i)=q(j\to i)A(j\to i),\qquad i\neq j.\]这里提议概率满足 \(\sum_iq(j\to i)=1\). 转移矩阵的对角元还要包含所有拒绝后留在原态的概率:
\[W(j\to j)=q(j\to j)A(j\to j)+\sum_iq(j\to i)[1-A(j\to i)].\]其中 \(q(j\to i)\) 是提议分布(如对称随机行走), \(A(j\to i)\) 是接受概率.
考虑所有可能转移后, 状态 \(i\) 的分布更新为:
\[w_i(t+1) = \sum_j\left[ w_j(t)q(j\to i)A(j\to i) + w_i(t)q(i\to j)(1-A(i\to j)) \right]\]第一项为接受后到达 \(i\) 的概率, 第二项为从 \(i\) 提议转移但被拒绝而留在原态的概率. 离散时间演化的差分为
\[w_i(t+1)-w_i(t) = \sum_j\left[ w_j(t)q(j\to i)A(j\to i) - w_i(t)q(i\to j)A(i\to j) \right]\]平衡时, 满足:
\[w_i(t+1)=w_i(t)\]即
\[\sum_j w_jq(j\to i)A(j\to i) = \sum_j w_iq(i\to j)A(i\to j)\]细致平衡条件是更强的条件, 每一项分别相等:
\[w_jq(j\to i)A(j\to i) = w_iq(i\to j)A(i\to j)\]等价于:
\[\begin{aligned} \frac{W(j\to i)}{W(i\to j)} &= \frac{w_i}{w_j},\\ \frac{q(j\to i)A(j\to i)}{q(i\to j)A(i\to j)} &= \frac{w_i}{w_j}. \end{aligned}\]Metropolis 算法通常取对称提议:
\[q(j\to i)=q(i\to j)\]并设:
\[A(j\to i) = \min\left(1,\frac{w_i}{w_j}\right)\]对于非对称提议分布 \(q(j\to i)\neq q(i\to j)\), 接受概率应取更一般的 Metropolis-Hastings 形式:
\[A(j\to i) = \min\left( 1, \frac{w_iq(i\to j)}{w_jq(j\to i)} \right).\]完整算法流程为:
选取初始状态 \(i\).
由当前状态 \(i\) 按提议分布抽取候选状态 \(j\sim q(i\to j)\).
计算接受概率
\[A(i\to j) = \min\left( 1, \frac{w_jq(j\to i)}{w_iq(i\to j)} \right).\]抽取 \(u\sim U(0,1)\).
若 \(u\leq A(i\to j)\), 则接受候选状态 \(j\); 否则停留在 \(i\).
丢弃前面若干步 burn-in, 对后续样本做统计平均.
当提议分布对称时, 上式退化为普通 Metropolis 接受率 \(\min(1,w_j/w_i)\).
8.6.1 Equilibrium Statistical Physics Application
在温度 \(T\) 下, 系统处于微观态 \(i\) 的概率满足 Boltzmann 分布:
\[w_i=\frac{\mathrm{e}^{-\beta E_i}}{Z}, \qquad \beta=\frac{1}{k_{\mathrm{B}}T}\]期望值:
\[\langle O\rangle = \sum_i O_iw_i = \frac{\sum_i O_i\mathrm{e}^{-\beta E_i}}{Z}\]直接计算期望值需要遍历所有状态, 这通常是难以实现的. Metropolis 算法只需要考虑能量差:
\[\frac{w_i}{w_j} = \mathrm{e}^{-\beta(E_i-E_j)}\]接收概率:
\[A(j\to i) = \min\left(1,\mathrm{e}^{-\beta(E_i-E_j)}\right) = \begin{cases} 1, & E_i\leq E_j,\\ \mathrm{e}^{-\beta(E_i-E_j)}, & E_i>E_j. \end{cases}\]新状态能量更低或相等, 总是接受; 若能量更高, 则以概率 \(\mathrm{e}^{-\beta(E_{i}-E_{j})}\) 接受.
8.7 MCMC Integration *
可以用 MCMC(Markov chain Monte Carlo) 方法来计算高维积分. 在 Bayesian 统计中, 后验分布是在给定观测数据后, 某个参数或一组参数的概率分布. Bayes 定理给出:
\[P(\theta|D) = \frac{P(D|\theta)P(\theta)}{P(D)}\]其中 \(P(\theta|D)\) 为后验分布, \(P(D|\theta)\) 为似然函数, \(P(\theta)\) 为先验分布, \(P(D)\) 为边际似然或证据.
以掷硬币为例. 设硬币正面的概率为 \(p\), 先验分布取为 \([0,1]\) 上的均匀分布:
\[P(p) = \begin{cases} 1, & 0\leq p\leq 1,\\ 0, & \text{otherwise}. \end{cases}\]如果抛 10 次硬币得到 7 次正面、3 次反面, 似然函数为
\[P(D|p) = \binom{10}{7}p^7(1-p)^3\]因此后验分布满足
\[P(p|D)\propto p^7(1-p)^3\]这是一个 Beta 分布. 后验分布的期望值为
\[E(p|D) = \int_0^1 pP(p|D)\,\mathrm{d}p = \frac{2}{3}\]实际的后验分布期望值在高维参数空间中通常难以解析求解, 此时可以使用 MCMC 近似计算. MCMC 积分通过构造一条平稳分布等于后验分布 \(p(\theta|D)\) 的 Markov 链, 再从链上抽取大量样本:
\[\int g(\theta)p(\theta|D)\,\mathrm{d}\theta \approx \frac{1}{N}\sum_{i=1}^{N}g(\theta_i)\]独立直接采样没有序列自相关, 但复杂目标分布往往难以直接抽取. Markov 链样本通常相关, 正相关会降低有效样本量, 负相关也可能提高它. 使用 MCMC 积分还要求目标分布确为平稳分布, 链满足相应遍历条件, 且观测量可积; 误差估计另需中心极限定理及自相关求和等条件, 不能只凭任意更新规则保证正确性.
8.8 Hamiltonian Monte Carlo *
HMC(Hamiltonian Monte Carlo) 是对 Metropolis 算法的一种改进, 通过引入动量变量和 Hamilton 动力学更高效地探索状态空间. 将目标分布 \(\pi(q)\) 视作势能分布:
\[\pi(q)\propto \mathrm{e}^{-U(q)}\]引入辅助动量变量 \(p\), 通常取独立正态分布:
\[\pi(p)\propto \mathrm{e}^{-K(p)}, \qquad K(p)=\frac{p^2}{2m}\]联合分布为
\[\pi(q,p) = \pi(q)\pi(p) \propto \mathrm{e}^{-H(q,p)}, \qquad H(q,p)=U(q)+K(p)\]Hamilton 方程为
\[\begin{aligned} \frac{\mathrm{d}q}{\mathrm{d}t} &= \frac{\partial H}{\partial p} = \frac{p}{m},\\ \frac{\mathrm{d}p}{\mathrm{d}t} &= -\frac{\partial H}{\partial q} = -\frac{\partial U}{\partial q}. \end{aligned}\]这里为简明取一维变量和 \(m>0\). 每次 HMC 更新先独立刷新 \(p\sim\mathcal{N}(0,m)\), 再用可逆且保持相空间体积的积分器生成轨迹. 常用蛙跳(leapfrog) 方法, 步长 \(h\) 的一步为
\[\begin{aligned} p_{1/2}&=p-\frac{h}{2}U'(q),\\ q_1&=q+\frac{h}{m}p_{1/2},\\ p_1&=p_{1/2}-\frac{h}{2}U'(q_1). \end{aligned}\]重复固定步数后翻转末动量, 得到可逆的确定性提议 \((q',p')\); 然后按能量差接受或拒绝. 若拒绝, 保留原位置; 最后只记录位置作为目标分布的样本. 接受概率为
\[A = \min\left(1,\mathrm{e}^{-H(q',p')+H(q,p)}\right)\]精确 Hamilton 流守恒能量, 此时接受率为 \(1\); 数值轨迹一般不精确守恒能量, 上述 Metropolis 步用于修正积分误差. 仅有能量差接受率不能修正任意不保持体积或不可逆的离散映射, 仍需满足提议的条件和链的遍历性.2
8.9 Quantum Monte Carlo *
QMC (Quantum Monte Carlo) 用 Monte Carlo 方法估计多体系统的基态能量.
Proposition 变分上界. 根据变分原理, 对任意依赖参数 \(\boldsymbol{\alpha}\) 的试探波函数 \(\phi(\mathbf{R},\boldsymbol{\alpha})\), 能量期望值满足
\[E_0 \leq \frac{\int \phi^*(\mathbf{R})\hat{H}\phi(\mathbf{R})\,\mathrm{d}\mathbf{R}} {\int|\phi(\mathbf{R})|^2\,\mathrm{d}\mathbf{R}}\]其中 \(\mathbf{R}\) 是所有 \(N\) 个粒子的坐标. 通过优化参数 \(\boldsymbol{\alpha}\) 使能量期望值最小化, 可以得到接近基态的波函数.
Definition 局部能量. 一般多体问题的 Hamiltonian 可写作
\[\hat{H} = -\frac{\hbar^2}{2m}\sum_{i=1}^{N}\nabla_i^2 + \sum_i V_{\mathrm{onebody}}(\mathbf{r}_i) + \sum_{i\lt j}V_{\mathrm{int}}(|\mathbf{r}_i-\mathbf{r}_j|)\]定义局部能量
\[E_L(\mathbf{R}) = \frac{\hat{H}\phi(\mathbf{R})}{\phi(\mathbf{R})}\]代入 Hamiltonian 得
\[E_L(\mathbf{R}) = \frac{ -\frac{\hbar^2}{2m}\sum_i\nabla_i^2\phi(\mathbf{R}) }{\phi(\mathbf{R})} + \sum_iV_{\mathrm{onebody}}(\mathbf{r}_i) + \sum_{i\lt j}V_{\mathrm{int}}(|\mathbf{r}_i-\mathbf{r}_j|)\]Remark 变分 Monte Carlo 的迭代流程:
选定含参数的 \(\boldsymbol{\alpha}\) 和 \(\phi\).
用 Monte Carlo 方法从概率密度
\[P(\mathbf{R}) = \frac{|\phi(\mathbf{R})|^2}{\int|\phi(\mathbf{R})|^2\,\mathrm{d}\mathbf{R}}\]中抽取样本, 并估计
\[\langle \hat{H}\rangle = \int P(\mathbf{R})\frac{\hat{H}\phi(\mathbf{R})}{\phi(\mathbf{R})}\,\mathrm{d}\mathbf{R}\]调整参数 \(\boldsymbol{\alpha}\), 使 \(\langle \hat{H}\rangle\) 最小化.
采样后即可直接计算积分:
\[\langle \hat{H}\rangle = \int P(\mathbf{R})E_L(\mathbf{R})\,\mathrm{d}\mathbf{R} \approx \frac{1}{N_{\mathrm{s}}}\sum_{k=1}^{N_{\mathrm{s}}}E_L(\mathbf{R}_k)\]这里 \(N_{\mathrm{s}}\) 是样本数, 与粒子数 \(N\) 不同; Markov 采样的标准误差应按局部能量的自相关作修正.
Remark Metropolis 采样. 下面考虑如何从 \(P(\mathbf{R})\propto|\phi(\mathbf{R})|^2\) 中取样. 使用 Metropolis 算法时, 取对称的位移提议分布; 如果当前构型为 \(\mathbf{R}\), 提议新构型 \(\mathbf{R}_p=\mathbf{R}+\Delta\mathbf{R}\), 计算比值:
\[w = \frac{P(\mathbf{R}_p)}{P(\mathbf{R})} = \frac{|\phi(\mathbf{R}_p)|^2}{|\phi(\mathbf{R})|^2}\]若 \(w\geq 1\), 总是接受; 若 \(w\lt 1\), 以概率 \(w\) 接受, 否则拒绝.
Example 一维谐振子. 以下取无量纲单位, 原势能参数固定为 \(k=2\):
\[\hat{H}=-\frac{\mathrm{d}^2}{\mathrm{d}x^2}+x^2\]Solution 严格求解波函数为
\[\phi_0(x) = \frac{1}{\pi^{1/4}}\mathrm{e}^{-x^2/2}\]试探波函数取 \(\alpha>0\):
\[\phi(x) = \frac{\sqrt{\alpha}}{\pi^{1/4}}\mathrm{e}^{-x^2\alpha^2/2}\]局部能量为
\[E_L(x)=\alpha^2+x^2(1-\alpha^4)\]于是
\[\langle \hat{H}\rangle = \int |\phi(x)|^2E_L(x)\,\mathrm{d}x = \frac{\alpha^2}{2}+\frac{1}{2\alpha^2}\]\(\alpha=1\) 时达到最小值, 得到基态能量 \(E_0=1\). 解析积分时必须将波函数归一化; 如果用 Monte Carlo 算法, 则无需显式处理归一化常数.
8.10 Diffusion Monte Carlo
DMC(diffusion Monte Carlo) 的核心思想是虚时投影加扩散分支. 令 \(\tau\) 具有能量倒数的量纲, 对 \(H=-D\nabla_R^2+V\), \(D=\hbar^2/(2m)\), 有
\[\partial_\tau\Phi=-(H-E_T)\Phi=D\nabla_R^2\Phi-(V-E_T)\Phi.\]本征态展开给出 \(\Phi(\tau)=\sum_n c_n\exp[-(E_n-E_T)\tau]\phi_n\). 若初态与目标基态重叠非零, 长虚时抑制高能分量. \(E_T\) 调节整体归一化, 不改变理想投影的本征态.
短时间动能传播是方差 \(2D\Delta\tau\) 的 Gaussian 随机位移; 势能传播用分支或权重 \(\exp[-(V-E_T)\Delta\tau]\) 实现. 对正的引导函数 \(\Psi_T\), 令 \(f=\Psi_T\Phi\), 改写为
\[\partial_\tau f=D\nabla_R^2f-\nabla_R\cdot(\vec v_Df)-(E_L-E_T)f,\qquad \vec v_D=2D\nabla_R\ln\Psi_T,\qquad E_L=\frac{H\Psi_T}{\Psi_T}.\]因此每一步包括漂移、扩散和依据局域能量的权重更新. 引导函数接近本征态时 \(E_L\) 涨落较小, 分支噪声减弱. 长时间采样的是混合分布 \(\Psi_T\Phi_0\), 而不是自动得到 \(|\Phi_0|^2\); 能量混合估计有特殊性质, 一般不对易可观测量仍有试探态偏差.
费米波函数变号使正权重抽样困难. 固定节点近似把试探节点作为零边界, 在各节点区域内投影. 对实局域 Hamiltonian, 理想固定节点能量是相应费米基态能量的上界; 节点错误不会随时间步减小而消失. 数值验收应分别检查时间步外推、群体大小、热化与自相关、节点依赖, 并用可解的小系统作基准.3
References
Ulrich Schollwöck, The density-matrix renormalization group in the age of matrix product states. ↩︎
Radford M. Neal, MCMC using Hamiltonian dynamics. ↩︎
Julien Toulouse, Roland Assaraf and C. J. Umrigar, Introduction to the variational and diffusion Monte Carlo methods. ↩︎