Music and Mathematics - 3
音乐与数学笔记(三)
On this page
9 Algorithmic Composition
9.1 Stochastic Composition
音乐骰子游戏 Musikalisches Würfelspiel
预先准备好若干已编号的音乐片段, 演奏时通过掷骰子决定选用哪个片段.
e.g.1 Kirnberger 《波洛涅兹和小步舞曲作曲常备》 游戏的关键在于Kirnberger的精心设计, 使得每一个小节的所有不同旋律都能和前一小节的任何一种旋律衔接.
e.g.2 Haydn(存疑) 《和声游戏: 无需对位知识便可以创作出无穷多小步舞曲和三声中部的简易方法》 小步舞曲与中部 (trio) 常按 A–B–A 的整体安排演奏; “trio” 的历史名称不表示所有中部都必须使用两只双簧管和一只 bassoon. 对讲义中所举的中部构造, 若两部分各 8 小节, 每小节可独立选 6 种片段, 则完整选择序列有 \(6^{16}\) 种. 计数依据是课程 Lecture 05, pp. 8–10 展示的 96 个编号片段及两张 6×8 选取表, 不保证所有选择在听觉上互异. Haydn 署名继续保留存疑, 不由讲义中的标题认定作者归属.
随机性与概率 随机变量、随机事件、概率分布、条件概率的基本概念不再赘述
ILLIAC组曲 Lejaren A. Hiller 与 Leonard M. Isaacson 借助 ILLIAC I 制作弦乐四重奏的作曲材料, 进行多组逐渐复杂的程序实验. 随机候选还须经过预先设定的音乐规则筛选, 并由人整理成谱; 不能把整部作品概括为对同一个音级集合的独立均匀抽样.
参见 伊利诺伊大学的 ILLIAC Suite 档案说明. 未指定实验、音阶、端点和休止符编码时, “两个八度共 31 个音级”也不足以确定一个可复现的采样模型.
带限随机序列的谱 研究随机旋律时, 必须先指定分析的是随时间变化的音高数值, 还是合成后的声波. 对一个离散音高序列, 功率谱密度描述不同时间变化频率上的方差分布, 不等于声波本身的音频频谱.
| 模型 | 在指定频段内的谱密度 |
|---|---|
| 白噪声 | 近似常数 |
| 粉红噪声 | 近似与频率的倒数成正比 |
| 棕噪声 | 近似与频率平方的倒数成正比 |
粉红噪声在等宽对数频带 (如相邻八度) 中功率相同, 因为 \(\int_f^{2f}\nu^{-1}\,d\nu=\log2\). 幂律只在指定频段内使用, 不能直接扩展到零频和无穷频, 也不是所有音乐必须满足的普遍规律.
9.2 Markov Chains
在同一个概率空间上定义的随机变量族称为随机过程. 这里只讨论离散时间、有限状态空间 \(S\) 上的过程 \(X_0,X_1,\ldots\).
Markov 性质 对具有正概率的历史事件, 要求
\[\Pr(X_{t+1}=j\mid X_0=i_0,\ldots,X_t=i_t) =\Pr(X_{t+1}=j\mid X_t=i_t).\]条件只包含已经发生的状态, 不包含待预测的 \(X_{t+1}\). 若转移概率不随时间改变, 称为齐次链, 可记
\[P_{ij}=\Pr(X_{t+1}=j\mid X_t=i),\quad P_{ij}\ge0,\quad \sum_jP_{ij}=1.\]初始分布 \(\pi_0\) 和矩阵 \(P\) 共同决定链; 用行向量表示分布时, \(\pi_{t+1}=\pi_tP\).
Example 只使用 C、D、E 三个音类, 取
\[P=\begin{pmatrix} 1/2&1/2&0\\ 1/4&1/2&1/4\\ 1/2&0&1/2 \end{pmatrix},\qquad \pi_0=(1,0,0).\]从 C 开始, 下一音为 C、D 的概率各为 \(1/2\), 再下一步的分布为
\[\pi_2=(3/8,1/2,1/8).\]每一步按当前行采样便得到一条旋律. 若同时研究节奏, 可将状态改为“音类、时值”的组合. 有限状态一阶模型只保留局部转移规律, 不自动保证乐句或和声的长期结构.
高阶模型 对 \(t\ge m-1\), m 阶 Markov 性质为
\[\Pr(X_{t+1}=j\mid X_0,\ldots,X_t) =\Pr(X_{t+1}=j\mid X_{t-m+1},\ldots,X_t).\]把最近 m 个音组成新状态 \(Y_t=(X_{t-m+1},\ldots,X_t)\), 便可转成一阶链, 但状态数至多增为 \(|S|^m\). 训练数据不足时, 许多历史组合没有样本, 需要平滑、回退或降低阶数.
9.3 Genetic Algorithms
属于进化算法(Evolutionary Algorithm)的一种. 其核心思想是模拟自然选择与遗传机制, 通过"适者生存"的原则, 在解空间中迭代演化出近似最优解.
Step GA的标准流程
Encoding: 将问题的可行解表示为适合遗传操作的individual, 通常用string形式编码.
假定需要考虑的乐音体系包括\(n\)个音级, 且十六分音符为最短时值, 则:
- \(0\)代表休止符
- \(1,2,\ldots,n\) 代表对应的音级
- \(n+1\)代表延长
每个编码位置占一个十六分音符的网格单位. 延长符必须跟在可延长的音后面 (或事先另行定义延长休止的规则), 不能无条件作为首项; 交叉、变异后也须检查或修复这类合法性约束.
Initialize Population: 随机或启发式地生成一个由\(N\)个个体组成的Initial Population.
Fitness Evaluation&Termination Check:
使用预先定义的Fitness Function计算个体适应度\(f(i_k)\),用于衡量该个体在问题中的优劣程度
如何度量一段音乐的"好坏"? 音乐本身规律、统计结果、人机交互、ML……多项加权.
若满足终止条件, 如存在\(f(i)>\alpha\)则停止算法并输出最优解; 否则继续下一步.
Evolution:
Selection: 根据适应度值, 通过轮盘赌算法、锦标赛选择等从当前种群中选择个体作为parents.
Roulette Wheel Selection: 设当前种群为\(\{i_k\mid k=1,\cdots ,N\}\), 其适应度为\(f(i_k)\), 则\(i_l\)成为parent的概率为
\[\frac{f(i_l)}{\sum_{k=1}^Nf(i_k)}\]Crossover/Recombination: 对选中的 parents 按一定 crossover rate 进行配对, 并在其执行交叉操作(如单点交叉、多点交叉、均匀交叉等), 产生 offspring.
Mutation: 对子代个体按一定 mutation rate 对编码中的某些基因位进行随机改变(如翻转二进制位、扰动实数值等), 以维持种群多样性并避免早熟收敛.
Form New Population 用产生的 offspring 替换或与 parent 组合形成新一代种群(采用代际模型、精英保留策略等)
Return 若已经达到预设迭代次数\(M\), 则停止迭代; 否则回到 Fitness Evaluation, 进行下一轮迭代.
精英保留 (elitism) 可用于形成新一代: 直接保留当前最优的少量个体. 轮盘赌选择需保证适应度非负且总和为正; 若不满足, 应先变换分数或改用锦标赛选择. 遗传算法不保证找到全局最优解.
9.4 Music Information Retrieval
音乐信息检索 (MIR) 包括音高与节拍分析、曲目识别、相似性检索、流派分类等. 以音频分类为例, 先把波形转成能表达目标信息的特征, 再训练并评价模型.
MFCC Mel 频率倒谱系数的一种典型流程为
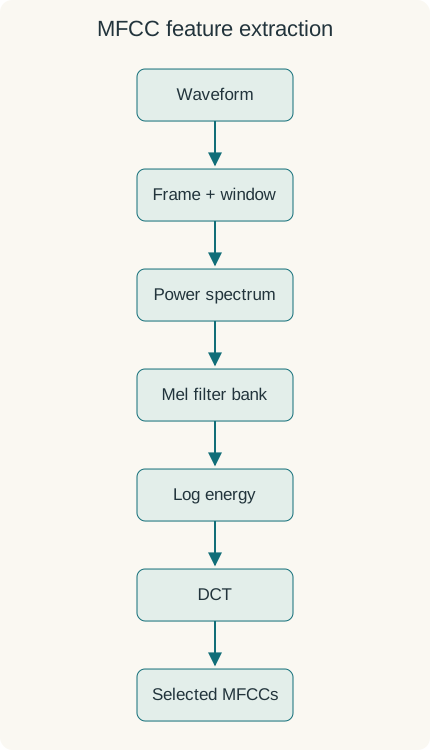
每帧功率谱经过 Mel 滤波器组得到能量 \(E_m\), 再对其对数作离散余弦变换. 略去归一化常数, 可写为
\[c_q=\sum_{m=0}^{M-1}\log(E_m+\varepsilon) \cos\left[\frac{\pi q}{M}\left(m+\frac12\right)\right].\]\(\varepsilon>0\) 防止对零取对数. 选择前若干系数概括谱包络; MFCC 不是保存完整旋律与音色的无损音频压缩格式.
若单声道音频有 \(N\) 个样本, 帧长 \(W\)、步长 \(H\) 为正整数, 且仅取完整帧、不作边界补齐, 则帧数为 \(1+\lfloor(N-W)/H\rfloor\) (\(N\ge W\)). 每帧保留 Q 个系数, 输出规模就是“帧数 × Q”. 因而固定 30 秒音频并不能唯一确定特征数量, 还必须说明采样率、帧长、步长与边界处理.
训练、验证与测试数据承担不同作用. 同一曲目的相邻片段不宜随机分散到训练集和测试集, 否则模型可能借助录音特征而非所需音乐规律得到过高分数. 按曲目或演奏者分组取决于实际评价目标.
9.5 Generative Models for Music
音乐生成可以使用符号表示 (音高、起音、时值等事件), 也可以生成波形或时频表示. 两者解决的问题不同: 前者仍需音源合成, 后者需处理更长的序列与音色细节.
Diffusion model 以前向加噪过程和学习到的反向过程建模. 以 DDPM 为例, 训练时随机选择噪声水平, 可以直接采样相应的含噪数据来学习预测噪声; 生成时从噪声出发逐步反向采样. 参见 Ho, Jain 与 Abbeel 的 Denoising Diffusion Probabilistic Models, §§2–3.4; 原论文研究图像生成, 此处借用其训练与采样框架. 模型学习的是数据分布的近似, 不意味着任意噪声输入都对应一首具有完整音乐结构的作品.
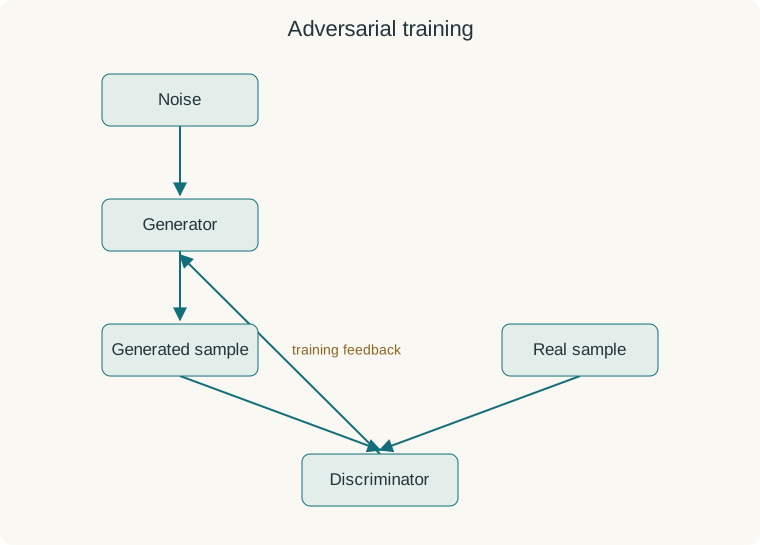
GAN 判别器学习区分真实样本和生成样本; 生成器利用判别器的反馈更新. 两者交替优化:
Transformer 注意力把每个位置的查询与可见位置的键比较, 将相应的值加权求和:
\[\operatorname{Attention}(Q,K,V)= \operatorname{softmax}\left(\frac{QK^{\mathsf T}}{\sqrt{d_k}}+M\right)V.\]这里 \(Q,K,V\) 分别为查询、键、值矩阵, \(d_k\) 为查询与键向量的维数; \(QK^{\mathsf T}\) 的每一行对应该查询对各键的评分. 掩码 \(M\) 与评分矩阵同形, 允许位置取 0, 禁止位置取 \(-\infty\), 每行须至少保留一个位置. softmax 按行计算. 自回归生成时, 掩码禁止读取未来位置; 训练输入还须相对预测目标错开一项, 并通过位置编码等机制提供顺序信息. 训练中可并行计算已知序列各位置的表示; 逐 token 生成仍依赖先前输出, 不能把它描述为所有输出都彼此独立地并行产生.
这些模型并不替代前述节奏、音类与和声分析; 那些结构可以用于设计表示、条件或评价指标.
10 Appendix: Musical Texture
- 复调音乐 (Polyphony): 指由两个或以上相对独立的旋律声部同时进行、并在节奏与音高上相互作用而形成的音乐形态. 多声部音乐还包含以主旋律与和弦伴奏组织的主调织体 (homophony), 因而多声部不全是复调. 复调强调各声部的独立性与对等性, 常见于文艺复兴、巴洛克时期的复调音乐传统中
- 赋格(Fugue): 是一种复调体裁或写作方式, 以主题 (subject) 及其答题 (answer) 等材料在不同声部依次进入、模仿并展开. 可通过转调、倒影、逆行、扩大或缩小等对位技术发展素材, 但不要求每部赋格都使用全部这些技术. 巴洛克时期(如巴赫作品)中尤为典型
11 References
- 王杰, 音乐与数学课程讲义, 2025 年秋季.
- Robert Hutchinson, Music Theory for the 21st-Century Classroom: 节拍、音类集合与十二音技术.
- Normal Form 与 Prime Form: 紧凑性并列规则的约定.
- Godfried Toussaint, Rhythm and Melody: 节奏的几何分析.
- Introduction to Speech Processing: MFCC: 对数 Mel 谱与倒谱系数.